최근 DevLog 프로젝트를 모듈러 아키텍처로 전환했습니다.
처음에는 어려운 지점이 파일 이동이나 빌드 오류일 것이라고 생각했습니다. 그런데 실제로 더 신경 쓰였던 문제는 따로 있었습니다. 빌드는 통과했지만 아키텍처 기준이 흐려지는 경우였습니다.
특히 AI가 아키텍처 기준이 명확하지 않은 지점에서 질문하지 않고 스스로 판단하는 일이 반복됐습니다.
아래 내용은 아키텍쳐 전환 중 주로 고민했던 지점들입니다.
- 어떤 타입을
Core혹은Domain에 둘 것인가 - Firebase 의존성은 어느 레이어까지 허용할 것인가
- Repository 구현체는 어디까지
Infra를 알아도 되는가 - Widget 모듈은
App,Domain,Data중 어디까지 접근해야 하는가 - 공통으로 쓰인다는 이유만으로 상위 모듈로 올려도 되는가
AI에게 기준이 충분히 주어지지 않으면 AI는 빈칸을 질문으로 남기기보다 그럴듯한 추론으로 채우려는 경향이 있었습니다. 문제는 그 추론이 당장 빌드를 통과시키는 데는 도움이 될 수 있지만 장기적으로는 아키텍처 경계를 흐리게 만든다는 점이었습니다.
처음에는 프롬프트를 더 자세히 작성하면 해결될 문제라고 생각했습니다. 하지만 같은 문제가 반복되면서 이건 프롬프트의 문제가 아니라 AI가 작업하는 환경의 문제에 가깝다고 느꼈습니다.
그래서 Hermes와 Harness Engineering을 도입해보기로 했습니다.
문제는 AI의 코드 작성 능력이 아니었습니다
AI는 코드를 잘 찾고 빠르게 수정합니다.
하지만 아키텍처 작업에서 중요한 것은 코드를 수정하는 속도가 아닙니다. 어떤 변경을 해도 되는지, 어떤 변경은 멈추고 질문해야 하는지를 구분하는 것이 더 중요합니다.
예를 들어 어떤 타입이 여러 모듈에서 필요하다고 해보겠습니다. AI는 이를 보고 Core로 이동시키는 선택을 할 수 있습니다. Core는 여러 모듈에서 접근 가능하기 때문에 당장 문제를 해결했다고 생각할 수 있습니다.
하지만 이 타입이 도메인 의미를 가진다면 이야기가 달라집니다. 단순히 여러 곳에서 필요하다는 이유만으로 Core로 올리는 순간 Domain의 책임이 흐려질 수 있습니다. 빌드는 통과하지만 아키텍처 기준은 약해집니다.
이 지점에서 AI에게 필요한 것은 더 많은 자유가 아니라 더 명확한 제약이었습니다.
AI가 결정해도 되는 것과 결정하면 안 되는 것을 분리해야 했습니다.
Hermes와 Harness Engineering
Hermes Agent는 Nous Research에서 만든 AI 에이전트 실행 환경입니다.
일반적인 챗봇처럼 답변만 생성하는 도구가 아니라 실제 개발 작업에 필요한 기능을 함께 제공합니다.
- 터미널 실행
- 파일 읽기 및 수정
- 코드 검색
- 브라우저 자동화
- 세션 기록 검색
- 지속 메모리
- 재사용 가능한 Skill 생성
- 서브에이전트 위임
- 크론 기반 자동화
- MCP 기반 외부 도구 연결
중요한 점은 Hermes가 단순한 AI 모델이 아니라는 점입니다.
AI 모델은 추론을 담당합니다. Hermes는 그 모델이 어떤 정보를 보고, 어떤 도구를 쓰고, 어떤 기록을 남기고, 어떤 절차를 따라야 하는지를 관리합니다. 즉 Hermes는 AI가 일하는 작업대에 가깝습니다.
여기서 Harness Engineering이 등장합니다.
Harness는 사람이나 물건을 로프에 고정하기 위해 사용하는 안전 장구를 의미합니다. Harness Engineering은 이 개념을 AI 작업 환경에 적용한 것으로 볼 수 있습니다.
AI가 안정적으로 일하려면 모델 성능만으로는 부족합니다. 모델이 어떤 플로우로 처리하는지, 어떤 도구를 사용할 수 있는지, 언제 멈춰야 하는지, 어떤 검증을 통과해야 완료로 판단할 수 있는 기준이 함께 설계되어야 합니다.
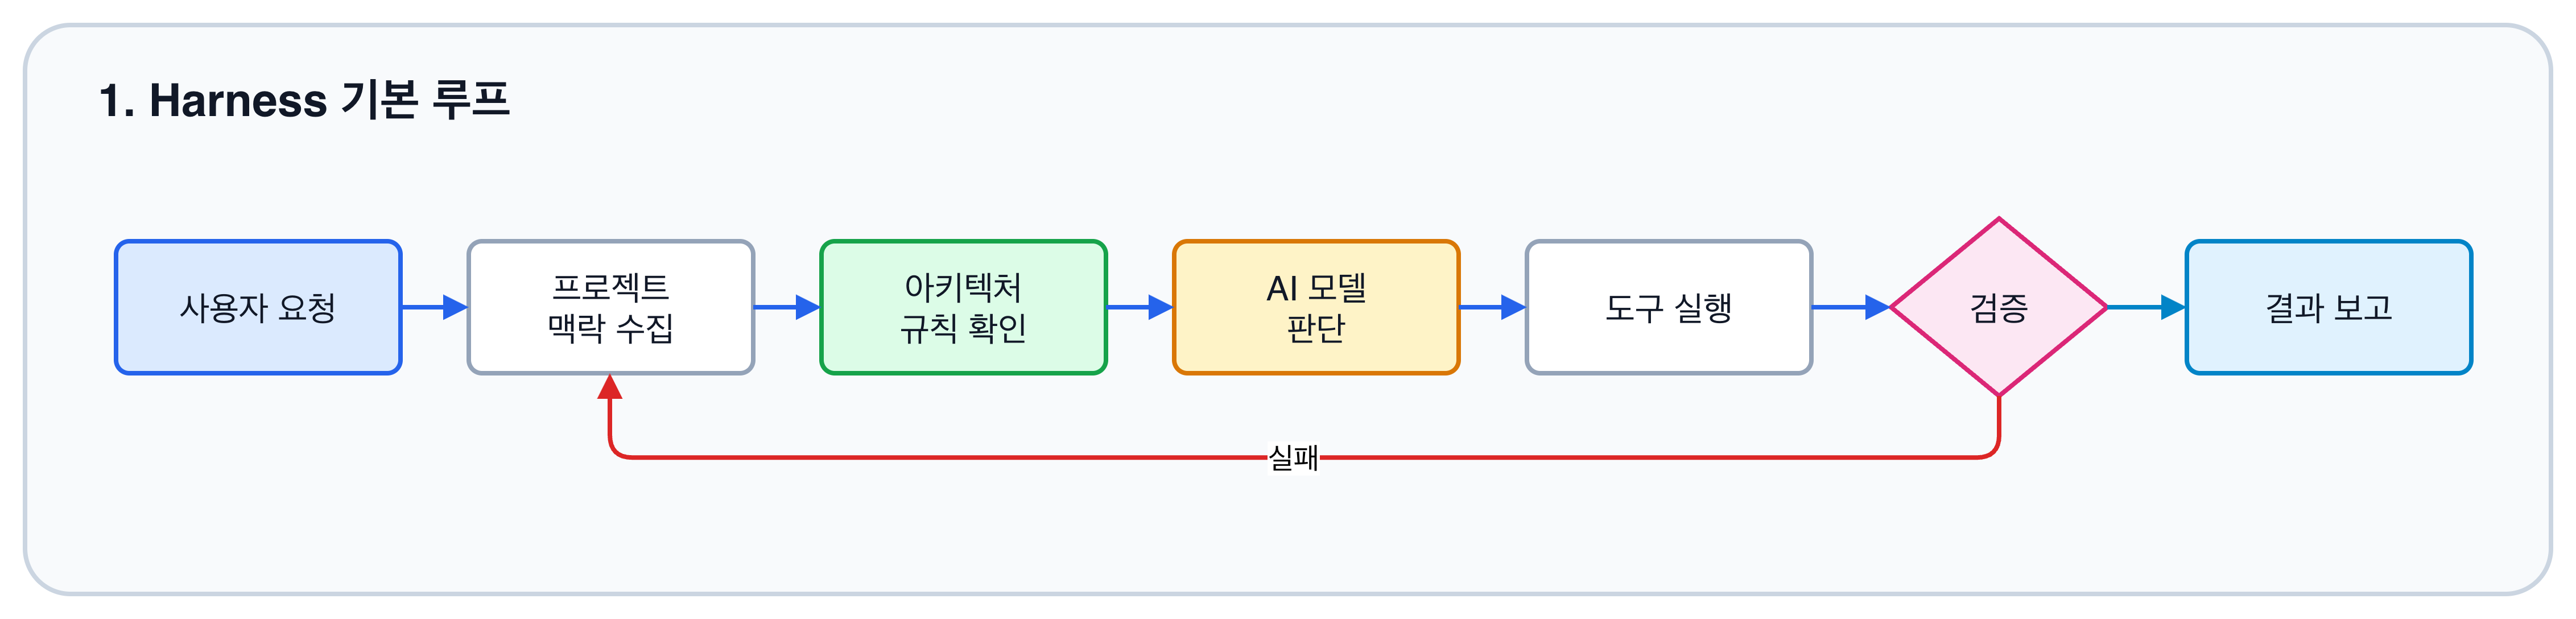
기존 방식에서는 사용자 요청이 곧바로 AI 판단으로 이어졌습니다. 반면 Harness를 도입하면 AI 판단 앞뒤에 규칙, 도구, 검증, 기록이 배치됩니다.
제가 기대한 것은 단순했습니다.
AI가 더 똑똑해지는 것이 아니라, 더 조심스럽게 움직이는 것입니다.
프로젝트의 규칙 위치
처음에는 AI 도구의 전역 메모리에 프로젝트 관련 작업 규칙을 남겨두는 방식도 생각했습니다. 하지만 곧 이 방식이 적절하지 않다고 판단했습니다.
아키텍처 기준은 프로젝트마다 다릅니다.
어떤 프로젝트에서는 Core가 정말 순수 유틸리티만 담을 수 있고, 어떤 프로젝트에서는 여러 모듈에서 공유하는 value type까지 포함할 수 있습니다. 어떤 프로젝트에서는 Widget이 Domain을 직접 알아도 괜찮을 수 있지만 제 프로젝트에서는 Widget이 snapshot 기반으로 동작하는 쪽이 더 적합했습니다.
즉 프로젝트의 아키텍처 기준은 각 프로젝트 레포 안에 있어야 합니다.
그래야 Codex, Hermes, 다른 AI 도구, 다른 세션에서도 같은 기준을 볼 수 있습니다. 전역 메모리는 과거 작업 맥락 정도만 참고하고 현재 기준은 레포 로컬 설정을 우선하도록 구성했습니다.
DevLog에는 다음 구조를 추가했습니다.
SwiftUI_DevLog/
├── AGENTS.md
└── .hermes/
	├── README.md
	└── skills/
		└── devlog-architecture-harness/
			├── SKILL.md
			└── references/
				├── devlog-architecture-flow.md
				└── devlog-workflow-rules.md
각 문서의 역할은 분리했습니다.
| 파일 | 역할 |
|---|---|
AGENTS.md |
레포 전체 AI 작업 규칙 |
.hermes/README.md |
Hermes Skill 설치 및 연결 방법 |
SKILL.md |
Hermes가 Skill로 인식하는 진입점 |
devlog-architecture-flow.md |
모듈 경계, 판단 게이트, 검증 흐름 |
devlog-workflow-rules.md |
PR, 커밋, Xcode, CI, Widget, Store 관련 작업 규칙 |
AGENTS.md에는 모든 AI가 반드시 따라야 하는 핵심 규칙을 둡니다. Hermes Skill에는 아키텍처 작업 시 실행할 절차를 둡니다. 상세 플로우와 과거 실패 방지 규칙은 reference 문서로 분리했습니다.
최종적으로 제 프로젝트에서는 이 플로우가 구성되었습니다.
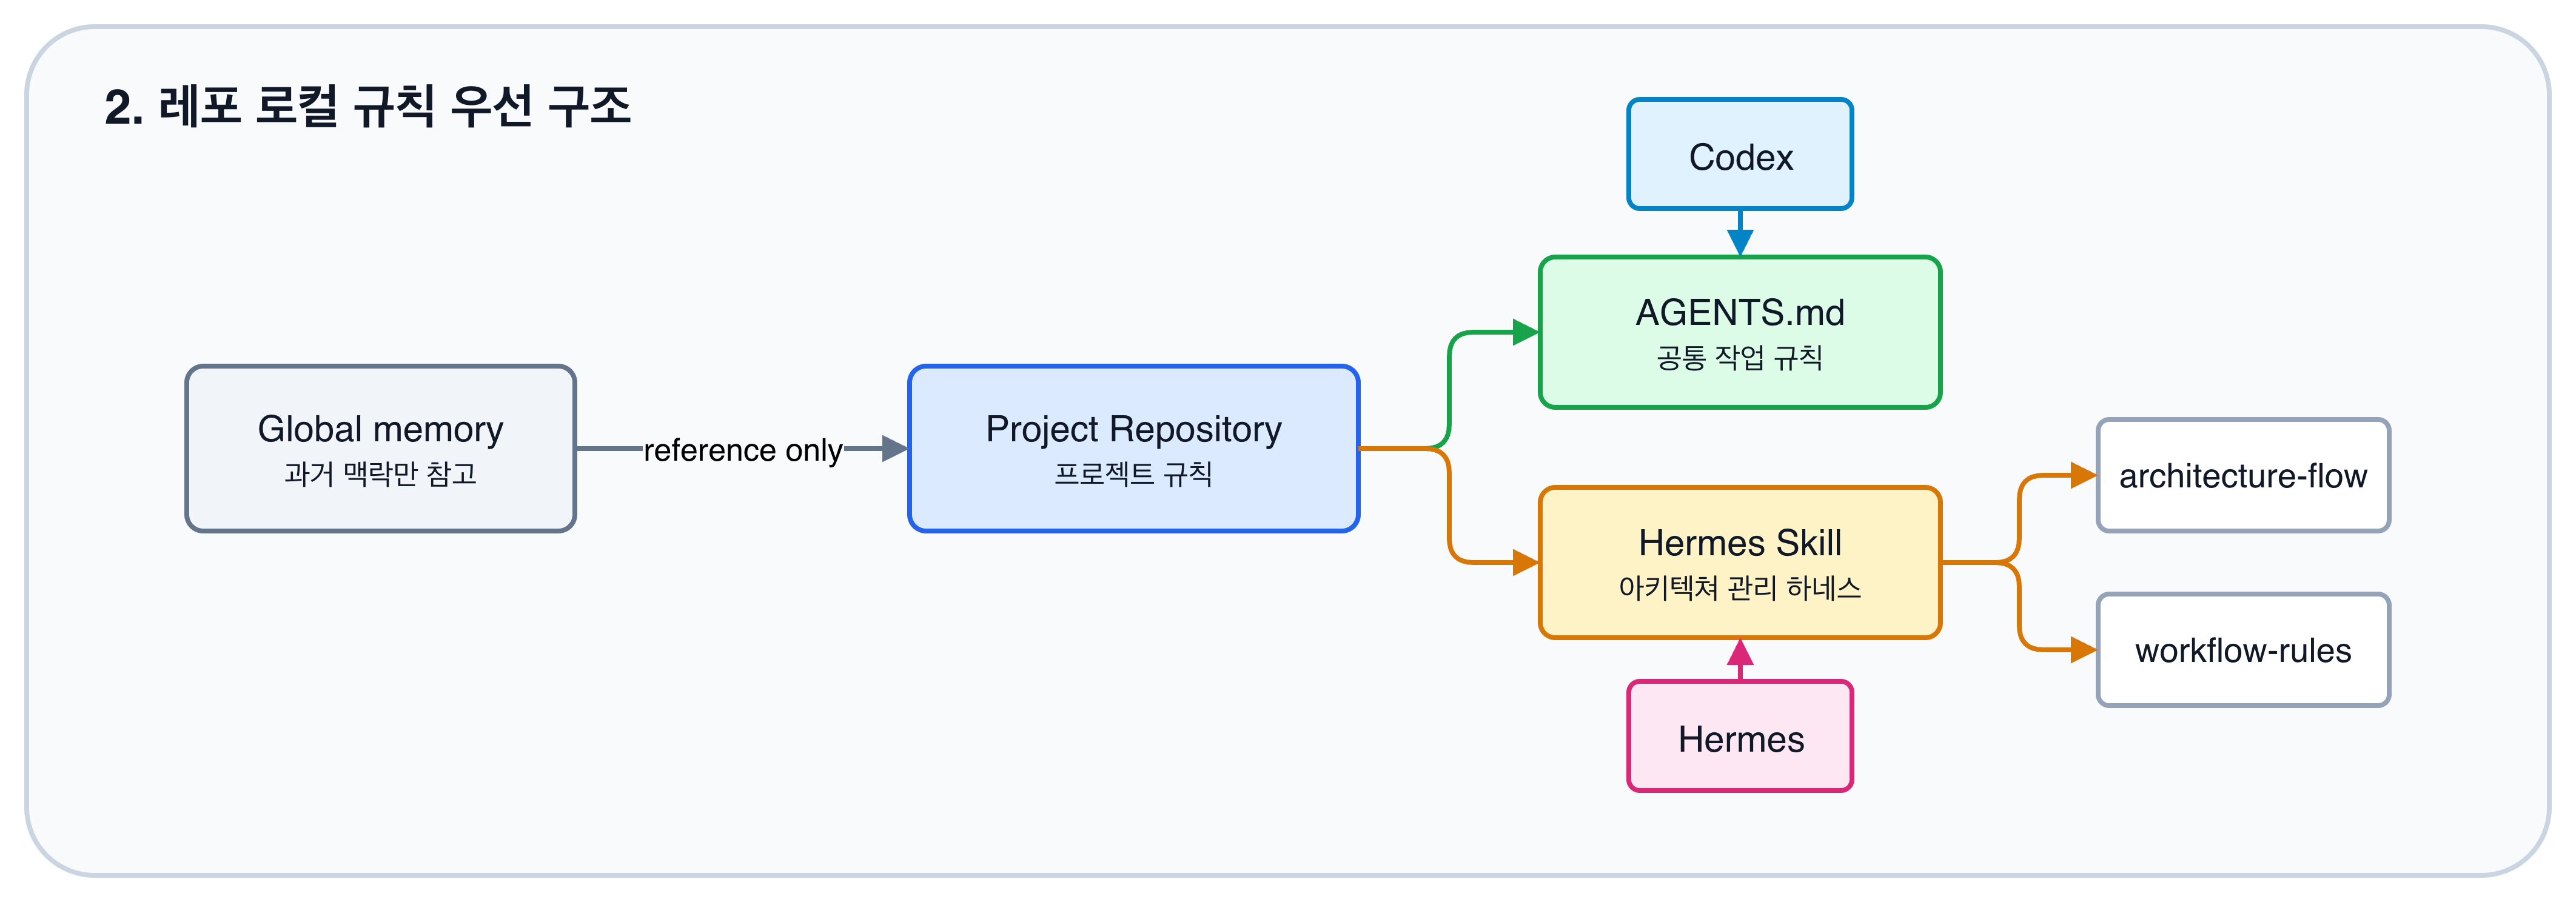
핵심은 전역 메모리보다 레포 로컬 규칙을 우선한다는 점입니다.
Hermes 설치와 프로젝트 연결
Hermes는 Homebrew로 설치했습니다. 최소 구성으로 uv와 hermes-agent만 설치했습니다.
brew install uv
brew install hermes-agent
설치 후 버전을 확인했습니다.
hermes --version
# Hermes Agent v0.14.0 (2026.5.16)
Homebrew 기준 설치 상태는 다음처럼 확인했습니다.
brew list --versions hermes-agent uv
# hermes-agent 2026.5.16
# uv 0.11.14
초기 설정은 다음 명령으로 진행합니다.
hermes setup
여기서 모델 제공자, API Key, 기본 모델 등을 설정할 수 있습니다.
설치 후에는 프로젝트 전용 Skill을 Hermes 사용자 Skill 디렉토리에 연결했습니다.
mkdir -p ~/.hermes/skills/project
ln -s /{레포 경로}/.hermes/skills/devlog-architecture-harness \
  ~/.hermes/skills/project/devlog-architecture-harness
symlink를 사용한 이유는 프로젝트 안의 설정 파일이 원본이 되어야 하기 때문입니다. 이렇게 하면 레포의 .hermes 내용을 수정했을 때 Hermes 쪽에도 바로 반영됩니다.
연결 후 Hermes에서 새 세션을 시작하고 Skill을 호출합니다.
/devlog-architecture-harness
Hermes는 자동 실행 도구가 아니라 보조 검토자
Hermes를 설치했다고 해서 Codex가 자동으로 Hermes로 전환되는 것은 아닙니다.
Codex와 Hermes는 각각 독립된 AI 실행 환경입니다. 일반적인 작업 요청은 Codex가 처리하고 Hermes는 필요할 때 명시적으로 실행합니다.
cd /{레포 경로}
hermes chat
혹은 하네스를 명시해서 실행할 수도 있습니다.
hermes --skills devlog-architecture-harness chat
모든 작업마다 Hermes를 실행할 필요는 없습니다. 모든 아키텍처 작업에 Hermes를 강제하면 속도가 느려지고 두 에이전트의 판단이 중복될 수 있습니다.
그래서 다음처럼 기준을 나누었습니다.
| 작업 유형 | 처리 방식 |
|---|---|
| 단순 import 정리 | Codex가 AGENTS.md 기준으로 처리 |
| 이미 승인된 파일 이동의 후속 수정 | Codex가 처리 |
| 문서와 현재 모듈 구조 동기화 | Codex가 AGENTS.md와 .hermes 기준으로 처리 |
| Core와 Domain 경계 판단 | Hermes read-only 검토 권장 |
| Data, Infra, Persistence 책임 경계 변경 | Hermes read-only 검토 권장 |
| DevLogWidget bridge 또는 widget sync 흐름 변경 | Hermes read-only 검토 권장 |
| WidgetCore 의존성 변경 | Hermes read-only 검토 권장 |
| Firebase, GoogleSignIn, WidgetKit 등 외부 SDK 위치 변경 | Hermes read-only 검토 권장 |
| 같은 레이어 내부 DI 추가 또는 변경 | Hermes read-only 검토 권장 |
Presentation StorePattern 책임 변경 |
Hermes read-only 검토 후 사용자 확인 |
| Xcode target dependency 변경 | Hermes read-only 검토 권장 |
| 대규모 모듈 경계 변경 | Hermes read-only 검토 후 사용자 확인 |
도입 전과 도입 후의 차이
도입 전에는 AI의 흐름이 비교적 단순했습니다.
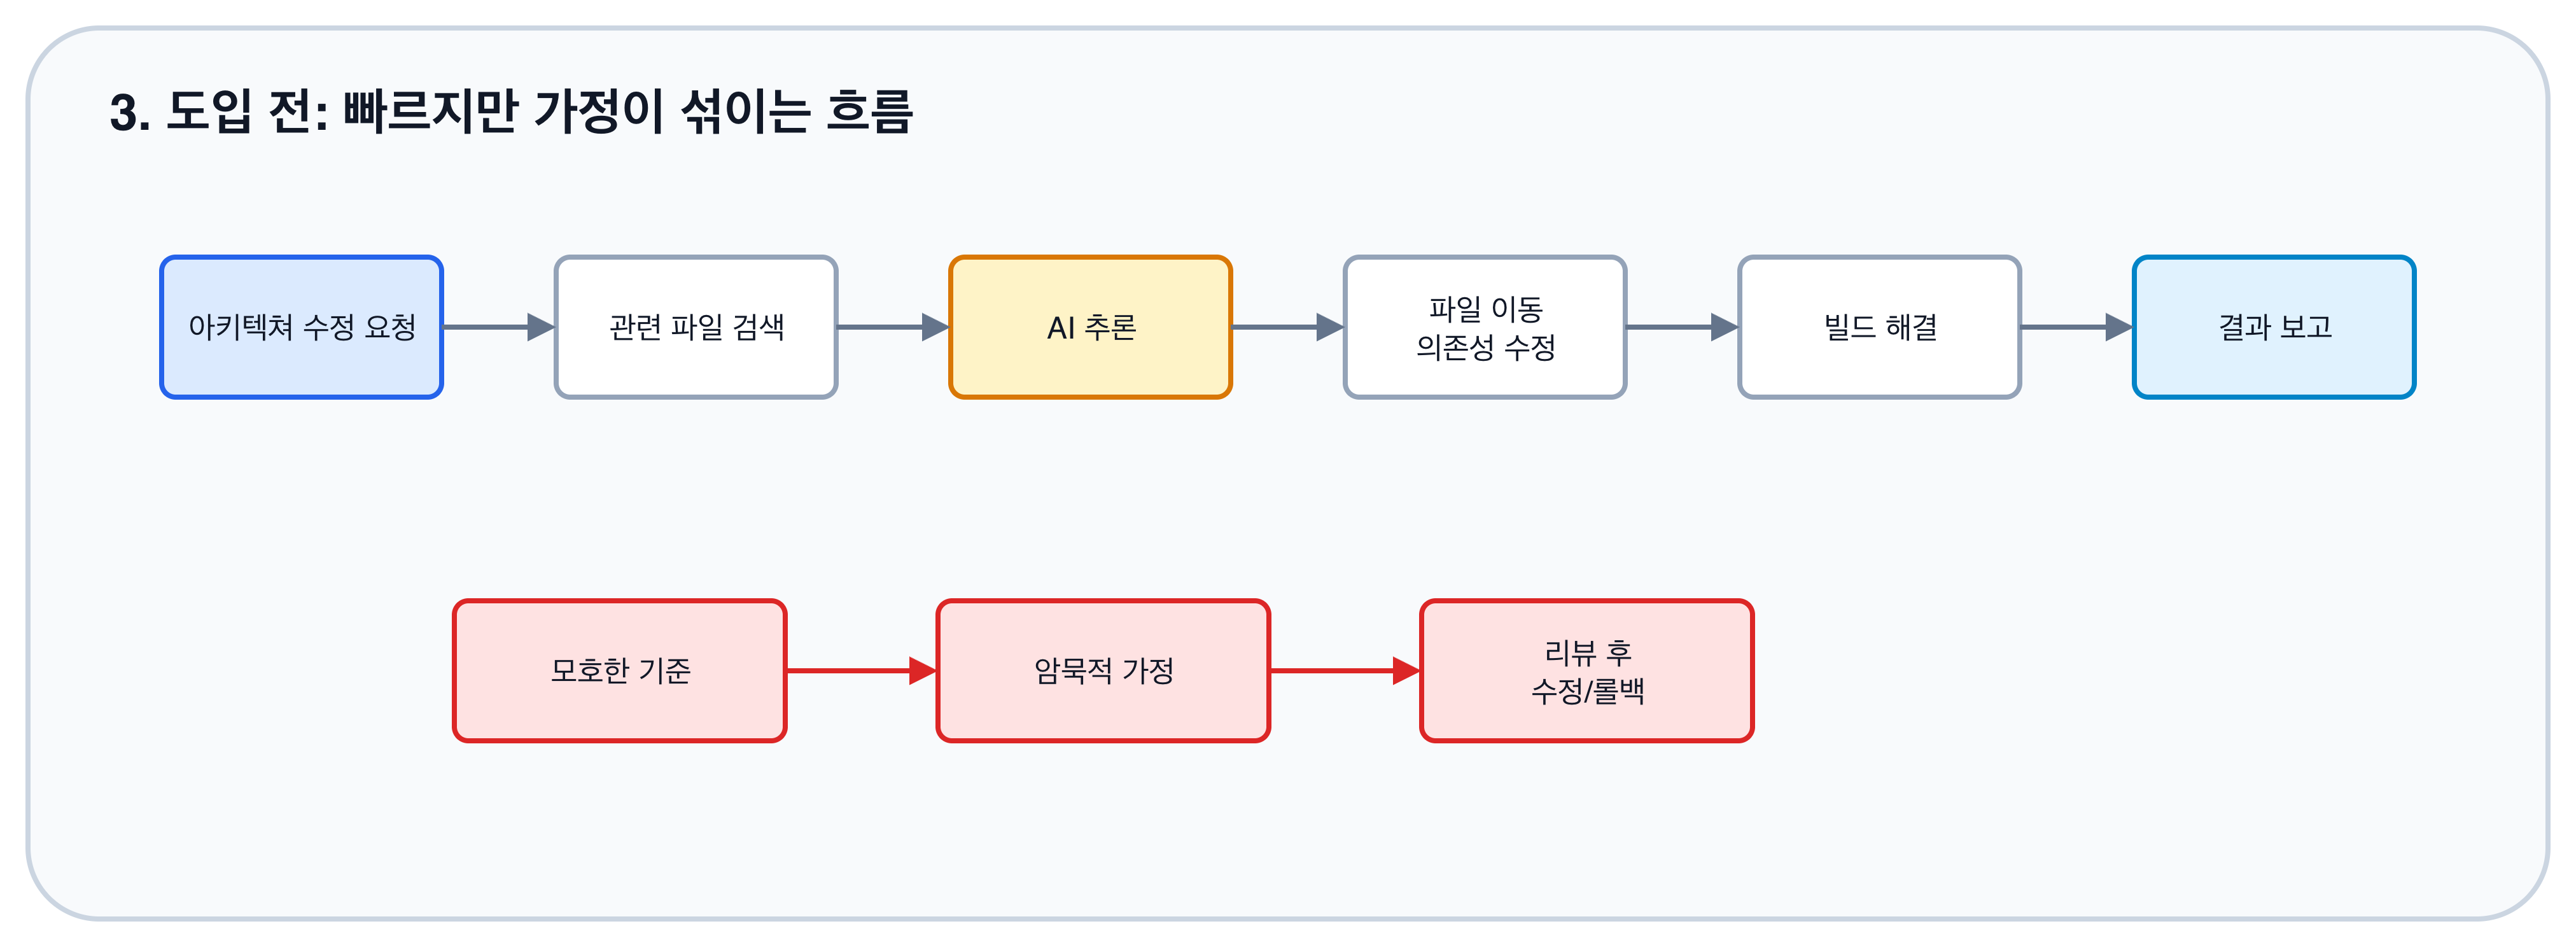
이 방식은 빠릅니다. 하지만 모호한 지점에서 AI가 가정을 만들기 쉽습니다.
도입 후에는 AI가 바로 수정하지 않습니다. 먼저 기준을 통과해야 합니다.
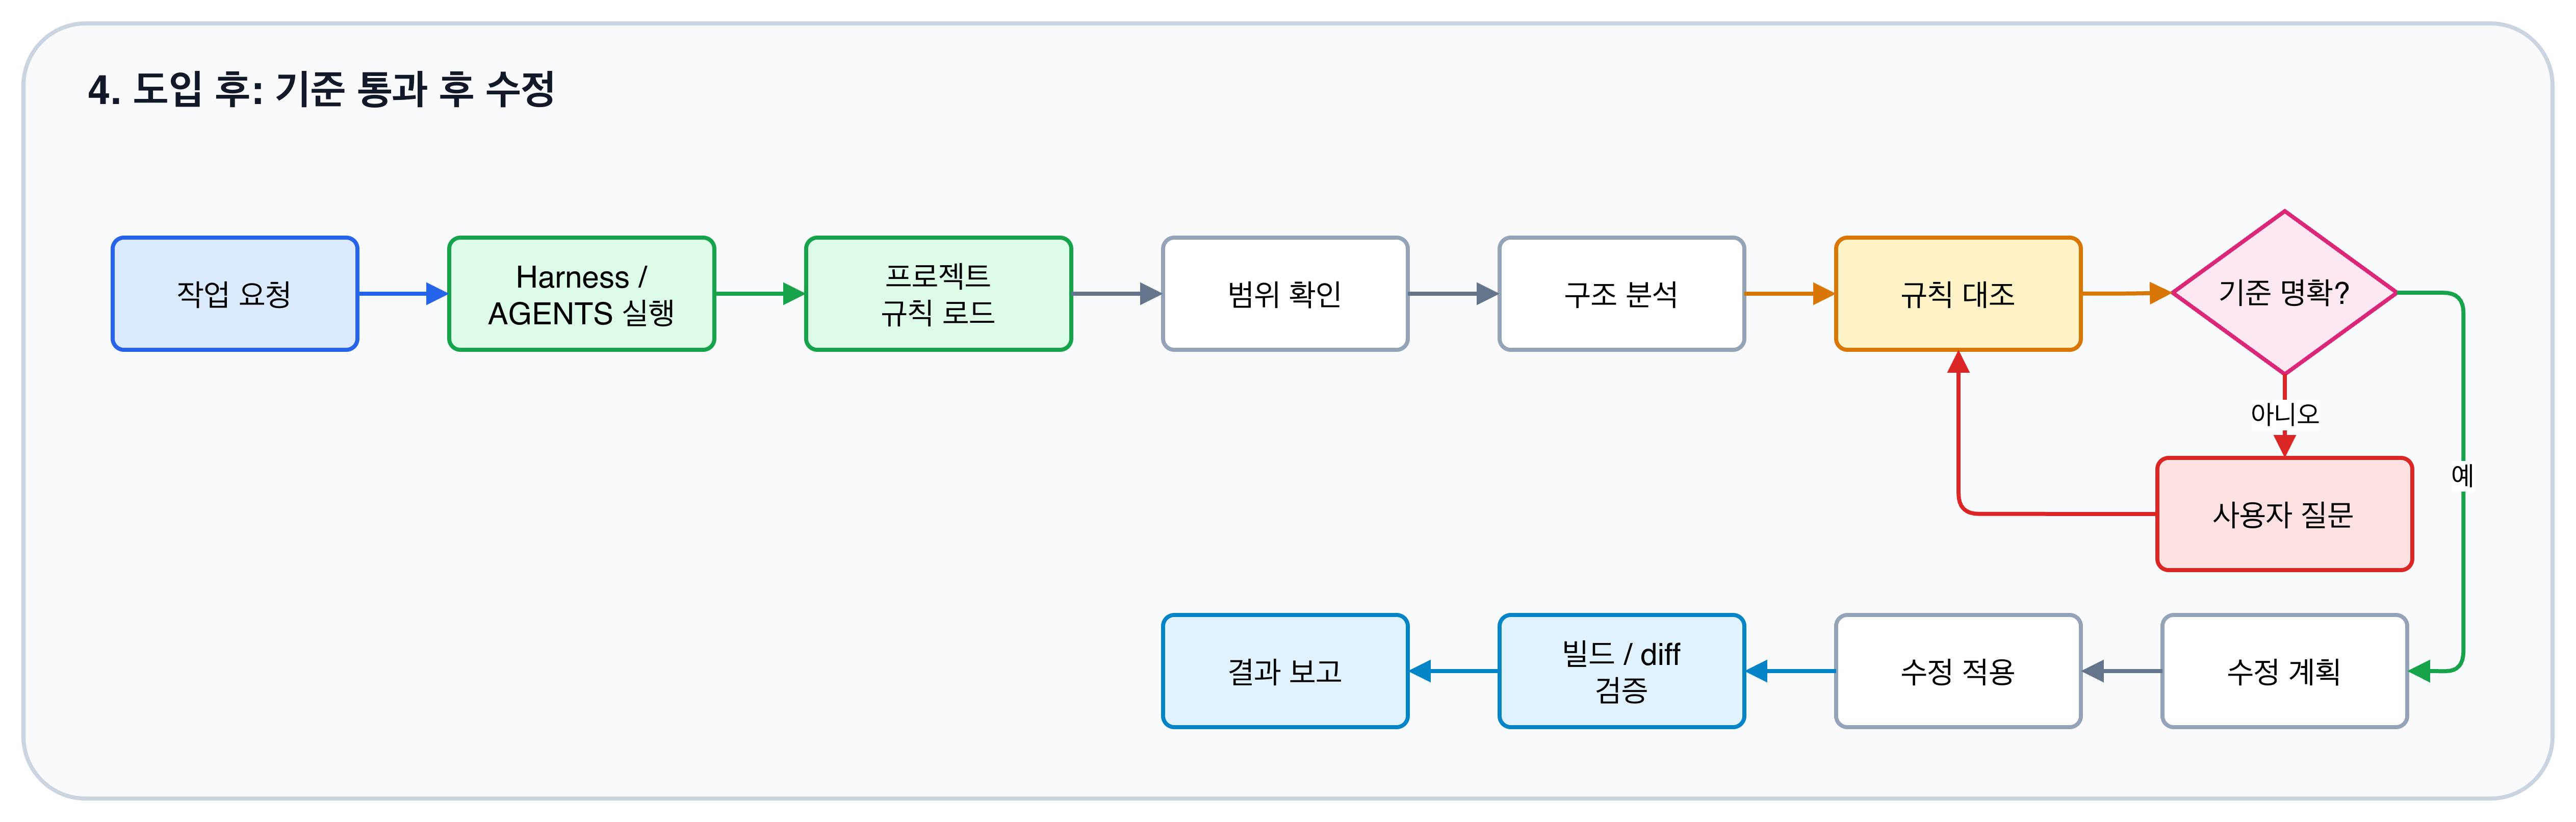
도입 후의 핵심 변화는 다음입니다.
- AI가 먼저 프로젝트 규칙을 읽습니다
- 변경 대상이 어떤 레이어 판단을 포함하는지 분류합니다
- 현재 Swift import와 Tuist target dependency를 함께 확인합니다
- 모호하면 수정하지 않고 질문합니다
- 변경 후에는 빌드뿐 아니라 diff 범위도 확인합니다
- 결과 보고에는 무엇을 바꿨는지와 왜 그 기준을 적용했는지가 함께 남습니다
이 흐름은 작업 속도를 약간 늦출 수 있습니다. 하지만 아키텍처 작업에서는 그 지연이 오히려 비용을 줄입니다. 잘못된 기준으로 빠르게 수정한 뒤 되돌리는 것보다 애매한 지점에서 한 번 멈추는 것이 더 싸기 때문입니다.
DevLog에 맞춘 Harness 기준
Harness 기준은 코드 세부 구현보다 플로우 중심으로 잡았습니다.
각 기준은 다음과 같이 정의했습니다.
| 기준 | 확인할 내용 |
|---|---|
| 레이어 영향 | App, Presentation, Domain, Data, Infra, Persistence, Core, DevLogWidget, WidgetCore, WidgetExtension 중 어느 레이어에 영향을 주는가 |
| 의존성 방향 | Swift import와 Tuist target dependency가 허용된 방향을 따르는가 |
| 소스 소유 | Xcode workspace와 target dependency가 실제 구조와 맞는가 |
| 외부 SDK | Firebase/Auth/Messaging 같은 SDK가 Infra 밖으로 새지 않는가 |
| Widget 경계 | DevLogWidget bridge, WidgetCore snapshot contract, WidgetExtension rendering 경계가 유지되는가 |
| 같은 레이어 DI | 같은 레이어 타입을 불필요하게 주입하지 않는가 |
| 빌드 검증 | iOS 변경 후 Xcode Local MCP 또는 build-only 명령으로 검증 가능한가 |
| 범위 제한 | 현재 요청과 무관한 안전성 수정으로 확장되지 않는가 |
이 기준을 Harness로 만들면 AI는 파일을 어디로 옮길까를 먼저 고민하지 않습니다. 먼저 이 변경은 어떤 기준을 건드리는가를 판단합니다.
Core와 Domain의 기준
DevLog의 현재 레이어 기준은 다음과 같이 정리했습니다.
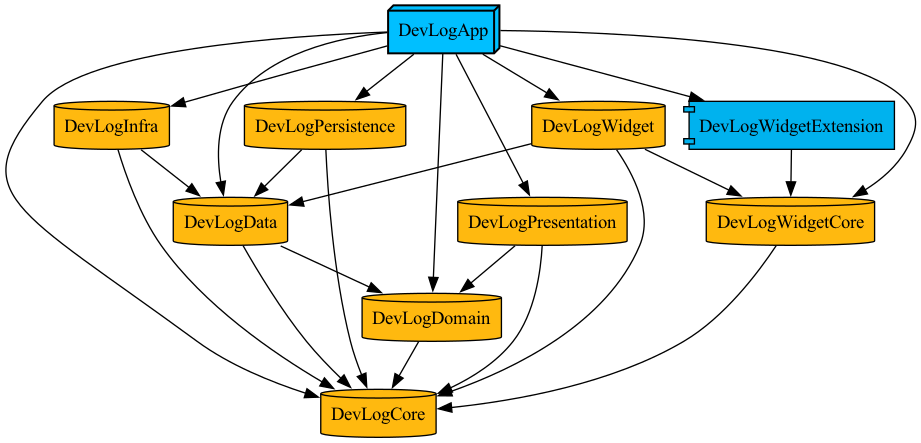
이 다이어그램에서 중요한 기준은 공유 가능성과 소유 책임을 분리하는 것입니다.
Core는 여러 모듈에서 접근할 수 있습니다. 하지만 여러 모듈에서 접근 가능하다는 이유만으로 모든 타입을 Core에 둘 수는 없습니다.
도메인 의미를 가지는 타입은 Domain에 남아야 합니다. 반대로 DI, Logger, 공통 query/value type, display option, activity kind, WidgetTodoSnapshot 같은 lightweight widget bridge value는 Core에 둘 수 있습니다.
Core와 Domain의 경계가 애매할 때는 다음 흐름을 사용합니다.
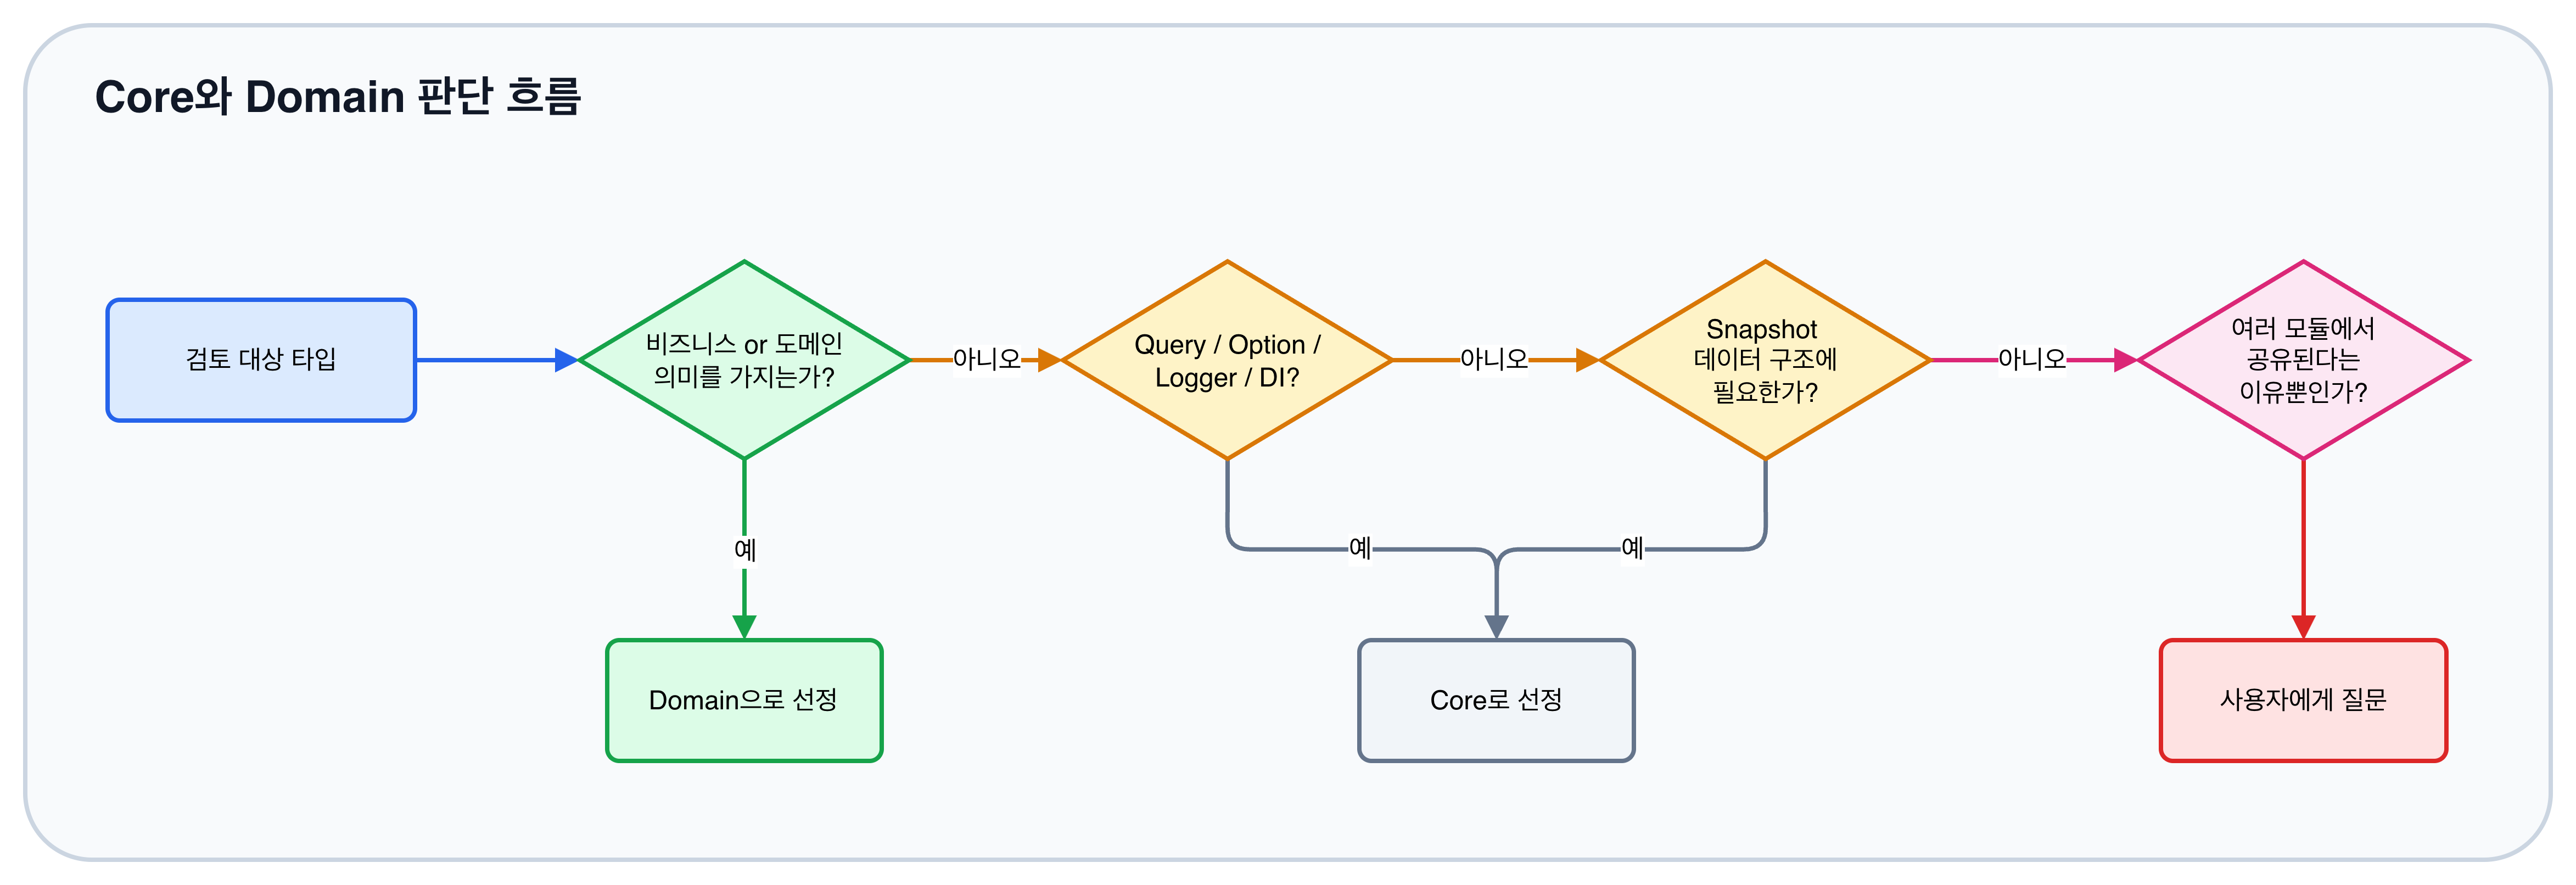
이 기준을 두면 AI가 공유되니까 Core라는 단순한 판단으로 넘어가지 못합니다.
Data, Infra, Persistence의 기준
DevLogData는 repository 구현, DTO, mapper, data-layer protocol, widget 관련 contract를 둡니다. 다만 Firebase, GoogleSignIn, WidgetKit, storage 구현 세부사항을 직접 소유하지 않습니다.
DevLogInfra는 Firebase, 소셜 로그인, 네트워크, 링크 메타데이터, messaging 구현을 담당합니다. 현재 기준에서는 source import뿐 아니라 Tuist target dependency에서도 DevLogDomain을 직접 의존하지 않아야 합니다. Data protocol이 Infra에서 구현되어야 한다면 protocol signature가 Infra에서 볼 수 있는 타입으로 유지되어야 합니다.
DevLogPersistence는 UserDefaults, image store, non-widget app persistence를 담당합니다. Widget snapshot 생성, snapshot persistence orchestration, WidgetKit reload는 DevLogPersistence가 아니라 DevLogWidget 쪽 책임입니다.
같은 레이어 내부 DI 기준
현재 하네스에는 같은 레이어 타입끼리의 dependency injection을 제한하는 규칙도 들어 있습니다.
같은 레이어 안에서는 initializer injection, stored-property injection, environment injection, DIContainer resolve를 통해 서로를 주입하지 않습니다. 예외는 Application/DevLogPresentation의 SwiftUI View 파일이 ViewModel, Coordinator, Store 같은 동일 Presentation 레이어 객체를 UI composition 목적으로 받는 경우입니다.
이 기준을 추가한 이유는 레이어를 나눴더라도 내부에서 불필요한 DI 그래프를 만들면 책임 경계가 흐려지기 때문입니다. 특히 build fix나 테스트 편의를 이유로 같은 레이어 객체를 주입하기 시작하면 실제로는 단순 생성이면 충분한 관계도 아키텍처 결정처럼 굳어질 수 있습니다.
Widget과 Presentation 상태 관리의 기준
현재는 Application/DevLogWidget, Widget/DevLogWidgetCore, Widget/DevLogWidgetExtension이 각각 다른 책임을 가집니다. 따라서 Widget을 하나의 모듈처럼 설명하기보다 app-side bridge, snapshot contract, WidgetKit rendering을 분리해서 봐야 합니다.
DevLogWidget은 앱 런타임과 위젯 시스템 사이의 bridge입니다. sync event bus implementation, sync/session handler, auth-session sync provider, snapshot generation/persistence orchestration, WidgetKit reload bridge, WidgetAssembler가 여기에 속합니다.
DevLogWidgetCore는 위젯이 읽을 snapshot model, factory, App Group key/defaults store, deep link, widget-only helper를 둡니다. DevLogWidgetExtension은 WidgetKit UI, provider, entry, timeline을 담당하고 DevLogWidgetCore가 만든 snapshot output을 소비합니다.
DevLogData는 widget 관련 contract와 snapshot input repository를 둘 수 있지만 concrete widget handler, WidgetCore factory 사용, WidgetKit reload behavior를 직접 소유하지 않습니다. DevLogPersistence도 UserDefaults, image store, non-widget app persistence에 머물고 widget snapshot orchestration을 갖지 않습니다.
현재 위젯 흐름은 다음처럼 정리할 수 있습니다.
App runtime/session event
	↓
WidgetSyncEventBus publishes .syncRequested
	↓
DevLogWidget WidgetSyncEventHandler
	↓
DevLogData WidgetTodoSnapshotRepository fetches snapshot inputs
	↓
DevLogWidget WidgetSnapshotUpdaterImpl
	↓
DevLogWidgetCore factories make widget snapshots
	↓
WidgetSnapshotStore saves snapshots to App Group storage
	↓
WidgetCenter reloads widget timelines
	↓
DevLogWidgetExtension provider loads snapshots and renders
Presentation 상태 관리도 도입 당시와 달라졌습니다. 기존 StorePattern은 아직 일부 ViewModel에 남아 있지만 대부분의 화면 상태 관리는 TCA Reducer, Store, TestStore 기준으로 이동했습니다.
따라서 현재 문서에서 StorePattern은 Presentation 전체의 대표 패턴이 아니라 남아 있는 legacy ViewModel의 보존 기준으로 봅니다. StorePattern이 남은 곳에서는 @MainActor, State, Action, SideEffect, send -> reduce -> run 흐름을 유지하고 I/O는 run이나 주입된 use case/service에서 처리합니다.
반대로 TCA로 이행된 화면에서는 reducer가 state 변경과 effect 반환을 담당하고 외부 작업은 dependency/effect 경로로 분리합니다. 이때 reducer, effect, dependency, ViewModel 사이의 책임을 옮기는 작업은 단순 리팩터가 아니라 Presentation 상태 관리 경계 변경으로 보고 먼저 확인해야 합니다.
기대한 변화 및 실제 적용
도입 전 AI는 다음처럼 행동할 가능성이 높았습니다.
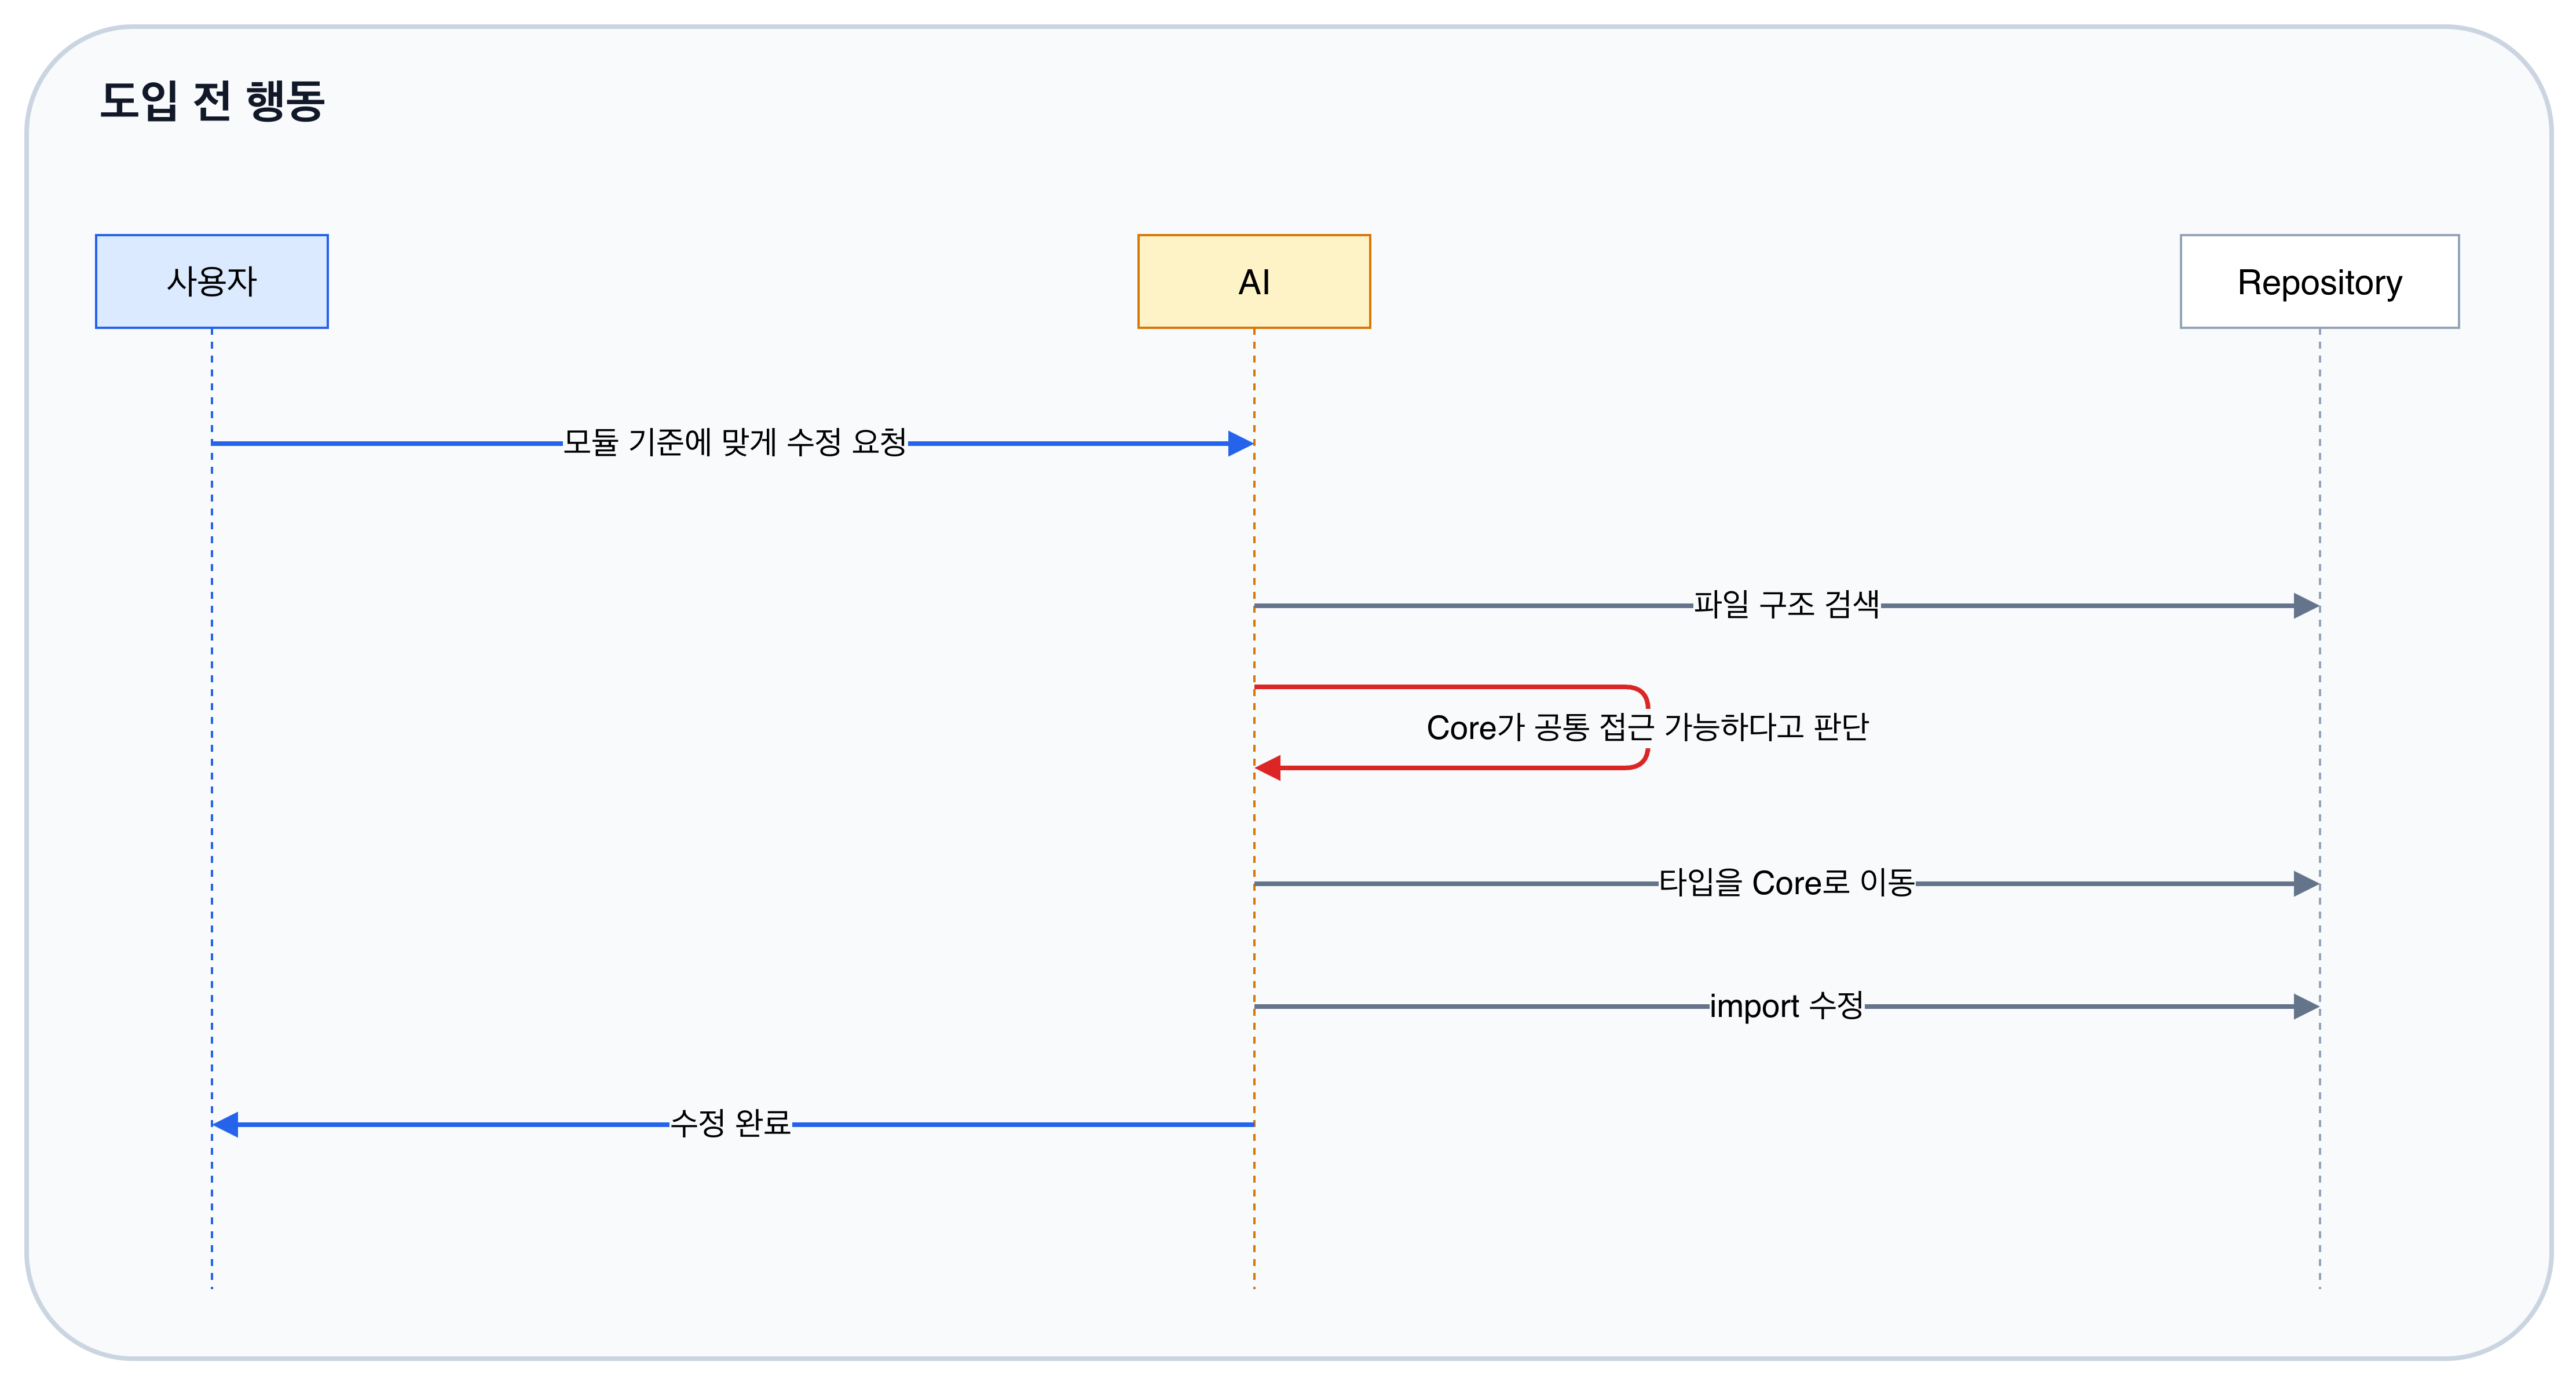
이 흐름에서는 사용자가 원하는 기준이 중간에 반영되지 않습니다.
도입 후에는 다음처럼 흐름을 바꾸고자 했습니다.
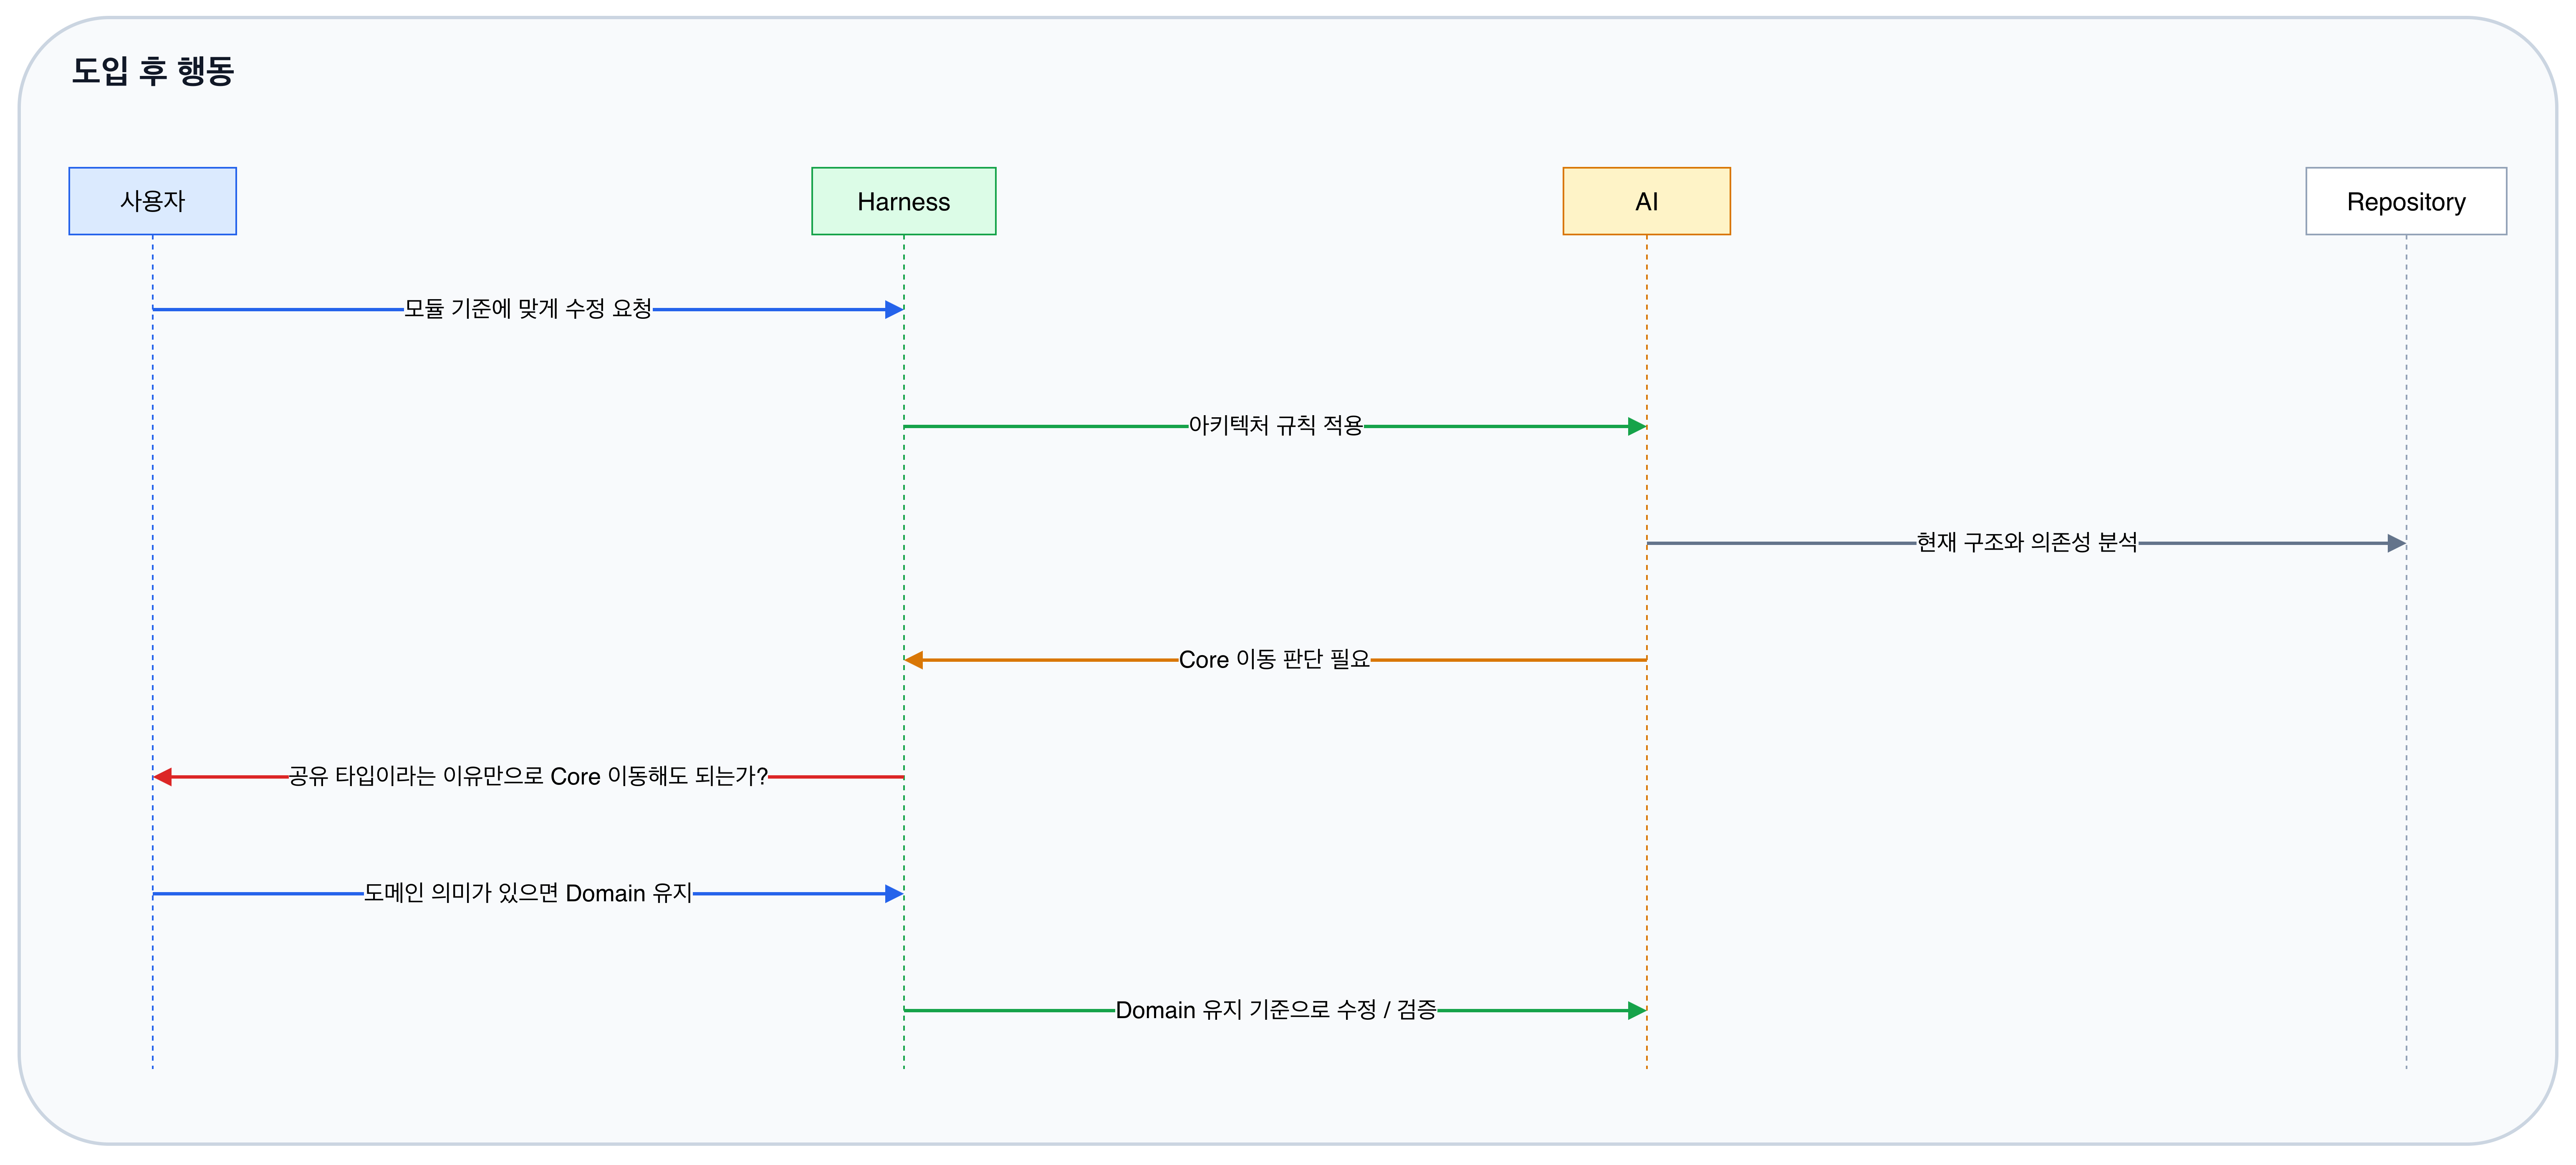
이 차이가 중요합니다.
도입 후에는 AI의 판단이 사라지는 것이 아닙니다. 다만 AI의 판단 앞에 질문 게이트가 생깁니다.
기대하는 효과는 다음과 같습니다.
- AI가 매번 다른 기준으로 파일을 이동하거나 의존성을 추가하는 일 감소
어떻게 할까요?가 아닌 구체적인 기준 확인 질문 증가- 리뷰 단계에서 뒤늦게 아키텍처 기준을 되짚는 비용 감소
AGENTS.md나 Hermes Skill을 통한 반복 기준 재사용- 빌드 오류 해결 과정에서 요청 범위 밖의 수정으로 확장되는 일 감소
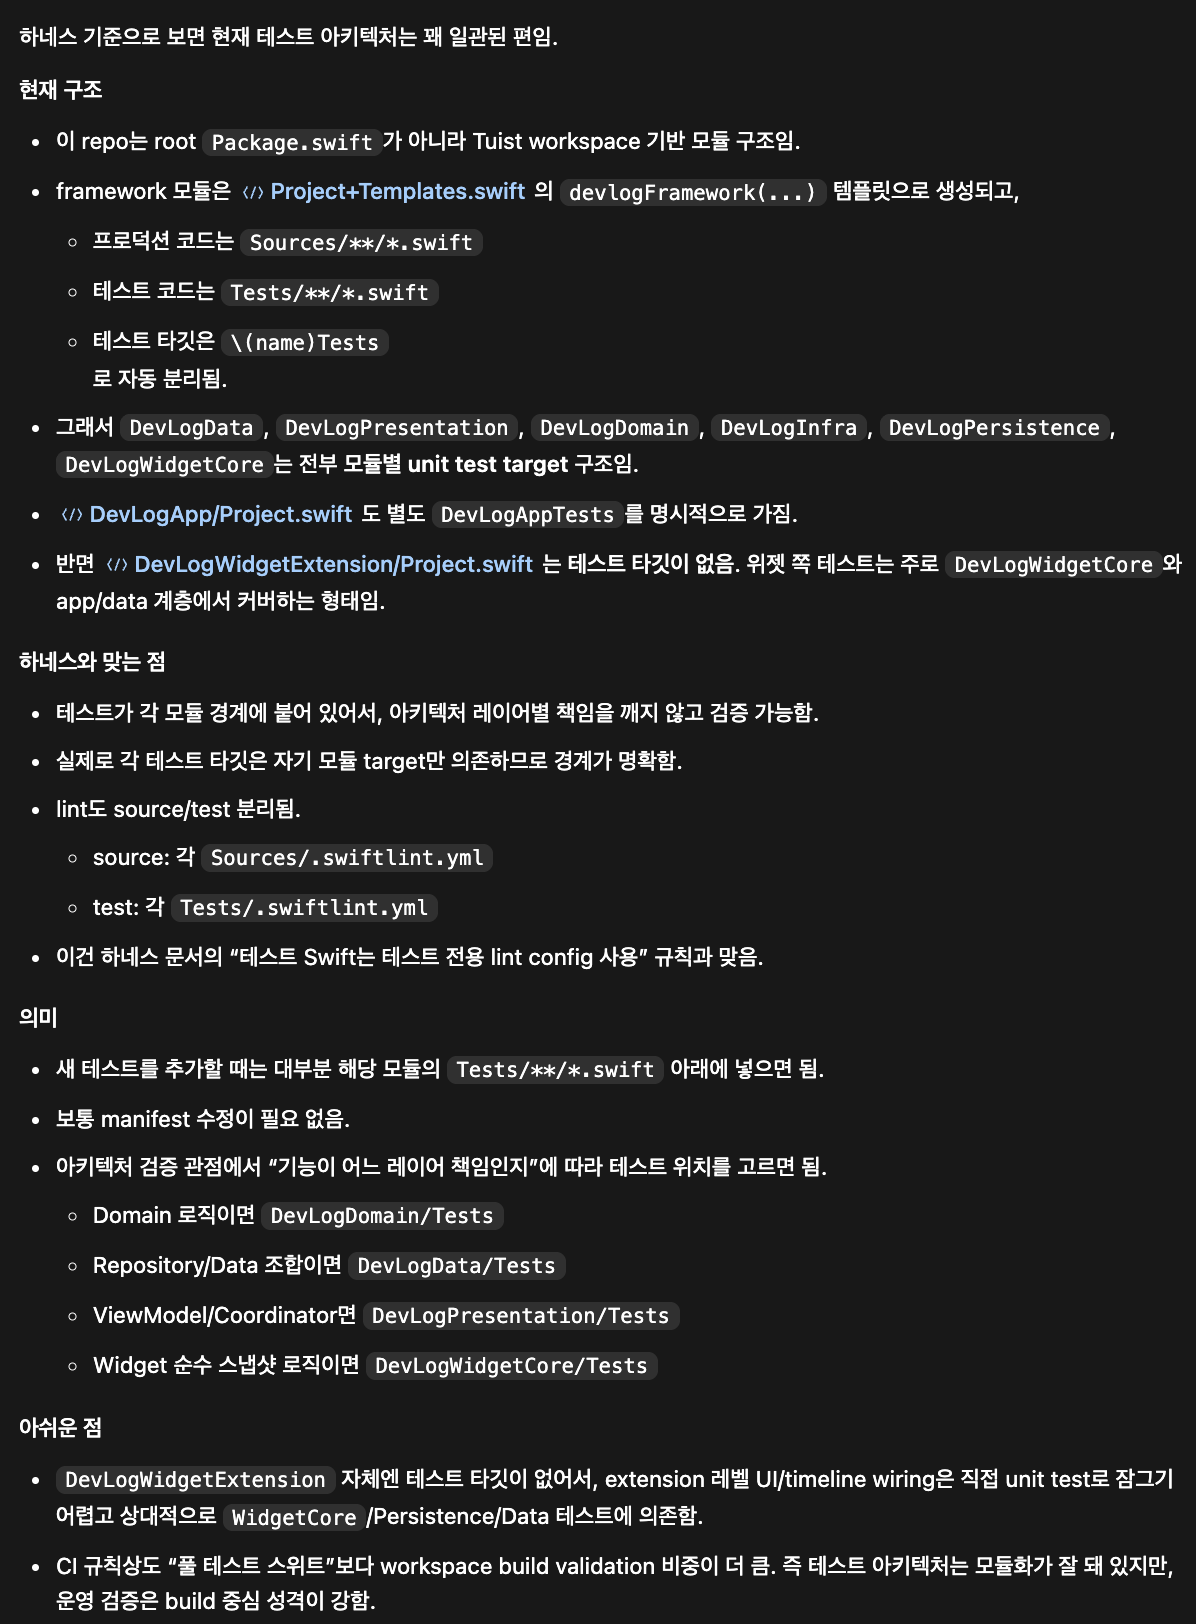
적용 후 분석 결과에 따른 아키텍쳐 적용
최종 정리
이번 문제의 본질은 AI가 코드를 잘못 작성했다는 것이 아니었습니다.
기준이 모호한 상태에서 AI가 질문하지 않고 판단했다는 점이었습니다.
모듈러 아키텍처는 코드 구조가 아니라 의사결정 구조에 가깝습니다. 어떤 타입이 어느 모듈에 있어야 하는지, 어떤 레이어가 어떤 구현을 알아도 되는지, 어떤 의존성을 숨겨야 하는지는 프로젝트의 규칙입니다.
Hermes와 Harness Engineering을 도입한다는 것은 이 규칙을 AI의 실행 흐름 안에 넣는 것입니다.
결론은 AI가 더 많은 결정을 하게 만드는 것이 아닙니다.
AI가 결정해도 되는 것과 결정하면 안 되는 것을 분리하는 것입니다.
이 기준이 만들어지면 AI는 모듈러 아키텍처를 그럴듯하게 수정하는 도구가 아니라 프로젝트의 경계 안에서 반복 가능한 방식으로 작업하는 도구가 됩니다.
최초 작성 전후 및 이후 반영된 PR
이 글은 2026년 5월 19일에 작성한 내용을 기반으로 수정되었습니다. 작성일 전후부터 이후까지 프로젝트 구조와 하네스 기준이 달라진 부분은 아래 PR들을 기준으로 다시 반영했습니다.
| 구분 | PR |
|---|---|
| 작성 직전 WidgetCore 의존성 정리 | [#473] WidgetCore 레이어에서 Domain 레이어 의존성을 제거한다 |
| 최초 Hermes 하네스 도입 | [#476] Hermes Agent를 사용하여 프로젝트의 아키텍쳐를 명세하여 AI의 작업 효율을 개선한다 |
| 모듈러 아키텍처 README 갱신 | [#477] 모듈러 아키텍쳐에 맞게 리드미를 수정한다 |
| Tuist 기반 workspace 구조 전환 | [#512] 프로젝트에 Tuist를 적용한다 |
| Tuist 생성 파일 추적 정책 정리 | [#516] Tuist generated file 추적 정책을 정리한다 |
| 위젯 싱크 트리거 수정 | [#511] 위젯 싱크 트리거를 수정한다 |
| 위젯 feature module 분리 | [#560] 위젯을 새로운 피쳐 모듈 기반으로 분리한다 |
| 하네스 의존성 방향 지침 갱신 | [#566] 하네스의 의존성 방향 지시문을 수정한다 |
| WidgetCore와 Persistence 의존성 분리 | [#568] WidgetCore 모듈에서 Persistence 모듈 의존성을 제거한다 |
| 최신 README 구조 갱신 | [#612] 업데이트된 구조 개선에 따른 리드미를 수정한다 |