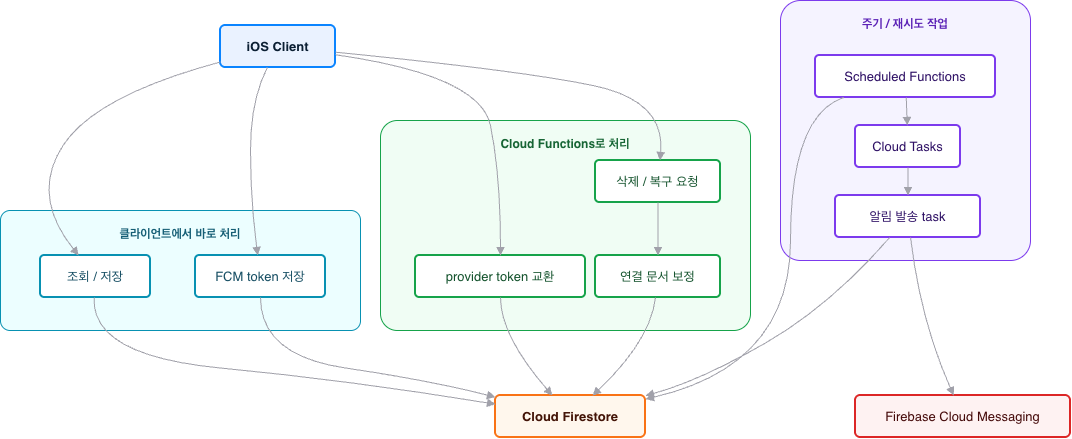
개인 iOS 앱을 만들면서 별도 서버를 직접 구축하지 않고 Firebase를 선택했다.
서버가 필요 없다고 판단했기 때문은 아니다.
로그인, 데이터 저장, 푸시 알림, 정기 작업처럼 서버가 맡아야 하는 책임은 분명히 있었다.
다만 초기 단계에서 직접 서버를 운영하는 것보다 Firebase가 제공하는 Auth, Firestore, Cloud Functions, FCM을 조합하는 편이 필요한 기능을 더 빠르게 구성할 수 있었다.
iOS Client
-> Firebase Auth
-> Cloud Firestore
-> Cloud Functions
-> Firebase Cloud Messaging
문제는 Firebase를 사용한다고 해서 서버에서 처리해야 할 일이 사라지지는 않는다는 점이다.
직접 서버를 만들지 않았을 뿐 여전히 어떤 작업은 클라이언트에서 처리하고 어떤 작업은 Cloud Functions로 옮길지 결정해야 한다.
기능이 늘어나면서 질문은 다음처럼 바뀐다.
이 작업은 클라이언트가 바로 처리해도 되는가?
서버에서 인증 정보를 다시 확인해야 하는가?
나중에 다시 실행되거나 정리되어야 하는가?
사용자 기기 상태와 무관하게 보장되어야 하는가?
Firebase를 선택한 이유는 직접 서버를 운영하지 않아도 필요한 서버 기능을 제품 조합으로 구성할 수 있었기 때문이다.
이 글에서는 Firebase 공식 문서의 기본 예제를 먼저 보고 개인 iOS 앱에서 인증, 데이터 저장, 푸시 알림, 정기 작업을 구성하며 어떤 작업을 Cloud Functions로 옮겼는지 정리한다.
Firebase 초기화는 앱 생명주기의 시작점이다
iOS에서 Firebase SDK를 사용하려면 앱 시작 시점에 Firebase를 초기화한다.
공식 문서의 기본 형태는 단순하다.
FirebaseApp.configure()
이 한 줄 이후부터 Auth, Firestore, Functions, Messaging SDK가 같은 Firebase 앱 설정을 기준으로 동작한다.
초기화 직후에는 Firebase와 연결되는 동기화 흐름도 함께 준비할 수 있다.
Client launch
-> FirebaseApp.configure()
-> FCM token 갱신 핸들러 등록
-> 사용자 timeZone 동기화 핸들러 등록
-> 알림 권한 요청
-> Messaging delegate 설정
여기서 핵심은 Firebase 초기화와 앱 내부 동기화 시작점이 분리되어 있다는 점이다.
FirebaseApp.configure()
-> Firebase SDK 사용 가능 상태 생성

토큰 동기화 핸들러
-> FCM token 변경 이벤트를 사용자 문서에 반영

타임존 동기화 핸들러
-> 앱 실행/foreground 진입 시 사용자 timeZone 반영
Firebase 초기화 자체는 작지만 앱이 Firebase에 어떤 상태를 언제 반영할지 정하는 시작점이 된다.
Auth는 사용자별 데이터 접근의 기준이다
Firebase Auth 공식 문서의 Google 로그인 흐름은 다음처럼 볼 수 있다.
let credential = GoogleAuthProvider.credential(
    withIDToken: idToken,
    accessToken: accessToken
)

Auth.auth().signIn(with: credential) { result, error in
    if let error {
        return
    }

    let user = result?.user
}
이 예제에서 Firebase Auth는 외부 제공자의 credential을 받아 Firebase 사용자로 로그인시킨다.
외부 provider credential
-> Firebase Auth signIn
-> Firebase user
실제 로그인 흐름도 기본 방향은 같다.
다만 provider마다 처리 위치가 달라진다.
Google
-> 클라이언트에서 provider credential 생성
-> Firebase Auth signIn

Apple
-> 클라이언트에서 authorization code / id token 획득
-> Callable Function에서 custom token 발급
-> Firebase Auth signIn(withCustomToken:)

GitHub
-> 클라이언트에서 authorization code 획득
-> Callable Function에서 access token / custom token 발급
-> Firebase Auth signIn(withCustomToken:)
Google은 클라이언트 SDK가 제공하는 credential 흐름으로 충분하다.
반면 Apple과 GitHub는 서버에서 다뤄야 하는 값이 있다.
Apple
-> client secret 생성
-> refresh token 보관
-> access token 갱신
-> revoke 요청

GitHub
-> client secret 사용
-> access token 교환
-> 이메일 보정 조회
-> revoke 요청
이 값들을 클라이언트에 직접 두면 secret 관리와 토큰 폐기 흐름이 약해진다.
그래서 Callable Functions를 인증 보조 서버처럼 둘 수 있다.
iOS Client
-> provider authorization code 획득
-> Callable Function 호출
-> Firebase Admin SDK로 사용자 조회/생성
-> custom token 발급
-> iOS Client에서 signIn(withCustomToken:)
즉 Auth는 단순히 로그인 여부를 알려주는 SDK가 아니다.
Auth.auth().currentUser?.uid
-> members/{uid}
-> members/{uid}/profiles/{document}
-> members/{uid}/items
-> members/{uid}/messages
따라서 대부분의 데이터 접근은 먼저 인증 상태를 확인한다.
guard let uid = Auth.auth().currentUser?.uid else {
    throw AuthError.notAuthenticated
}
이 코드는 단순한 방어 코드가 아니다.
Firestore 문서 경로와 서버 함수 호출이 모두 사용자 단위로 나뉘기 때문에 uid가 없는 상태에서는 작업의 기준 경로도 만들 수 없다.
로그인 완료 시점과 사용자 초기화는 다르다
Firebase Auth는 로그인 상태 변화를 빠르게 알려준다.
공식 문서의 기본 흐름은 다음처럼 볼 수 있다.
let handle = Auth.auth().addStateDidChangeListener { auth, user in
    if let user {
        // signed in
    } else {
        // signed out
    }
}
하지만 user != nil이 되는 순간을 곧바로 로그인 완료로 처리하기 어려운 경우가 있다.
로그인 직후에는 추가 초기화가 이어진다.
Firebase Auth signIn 성공
-> 사용자 기본 정보 저장
-> provider 정보 저장
-> FCM token 저장
-> 기본 설정 문서 생성
-> 카운터 문서 생성
-> 로그인 완료 상태 publish
이 초기화가 끝나기 전에 화면을 signed-in 상태로 전환하면 다음 화면이 아직 없는 Firestore 문서를 읽을 수 있다.
그래서 Auth state 변경을 그대로 UI 상태로 쓰지 않고 로그인 후 사용자 데이터 준비 구간을 둘 수 있다.
beginSignIn()
-> signedIn publish 지연

사용자 문서 초기화 완료
-> completeSignIn()
-> signedIn publish
Auth state는 Firebase가 알려주는 원천 상태이고 클라이언트 session state는 사용자 데이터 준비까지 포함한 상태다.
Firebase Auth state
-> user가 있는가?

Client session state
-> user가 있고 앱에서 필요한 기본 문서도 준비되었는가?
이 둘을 분리해야 로그인 직후의 빈 문서 조회 문제를 줄일 수 있다.
Firestore는 사용자 단위 계층 구조로 나눈다
Cloud Firestore 공식 문서의 기본 조회 예제는 문서나 컬렉션을 직접 읽는 형태다.
let snapshot = try await db.collection("cities").getDocuments()

for document in snapshot.documents {
    print(document.documentID)
}
실시간 변경이 필요하면 listener를 붙인다.
db.collection("cities").addSnapshotListener { snapshot, error in
    guard let snapshot else {
        return
    }

    for document in snapshot.documents {
        print(document.data())
    }
}
공식 예제는 컬렉션 하나를 기준으로 보여주지만 서비스 데이터에서는 사용자별 경계를 먼저 잡아야 한다.
Firestore 구조는 다음처럼 사용자 루트를 기준으로 나눌 수 있다.
members/{uid}
├─ profiles
│  ├─ basic
│  ├─ secrets
│  ├─ settings
│  └─ preferences
├─ counters
│  └─ item
├─ items
├─ messages
├─ deliveryRecords
└─ links
이 구조에서 members/{uid}는 사용자 루트다.
사용자 프로필
-> members/{uid}/profiles/basic

토큰
-> members/{uid}/profiles/secrets

알림 설정
-> members/{uid}/profiles/settings

표시 카테고리
-> members/{uid}/profiles/preferences

주요 항목
-> members/{uid}/items/{itemId}

알림 기록
-> members/{uid}/messages/{messageId}

발송 중복 방지 기록
-> members/{uid}/deliveryRecords/{recordId}
클라이언트와 Functions는 같은 경로 규칙을 사용한다.
Client path helper
-> 클라이언트 읽기/쓰기 경로 생성

Functions path helper
-> Admin SDK 읽기/쓰기 경로 생성
경로 문자열을 기능마다 직접 조립하지 않고 한 곳에 모으면 다음 장점이 있다.
collection 이름 변경 영향 축소
클라이언트와 서버의 사용자 경로 일관성 유지
문서 위치를 기능 코드보다 먼저 파악 가능
Firestore 쓰기는 생성 기준을 명확히 해야 한다
공식 문서의 쓰기 예제는 보통 다음처럼 단순하다.
try await db.collection("cities").document("LA").setData([
    "name": "Los Angeles",
    "state": "CA"
])
기본 쓰기는 setData(..., merge: true)로 처리할 수 있다.
문서가 없으면 생성
문서가 있으면 일부 필드 갱신
이 방식은 생성과 수정을 같은 흐름으로 처리할 수 있다는 장점이 있다.
다만 모든 필드를 매번 같은 방식으로 저장할 수 있는 것은 아니다.
문서를 처음 만들 때만 정해야 하는 값이 있을 수 있기 때문이다.
예를 들어 사용자가 보는 순번이나 생성 전용 메타데이터는 문서 생성 시점에만 부여되어야 한다.
이 값을 클라이언트에서 단순히 count + 1로 만들기는 어렵다.
동시에 두 기기에서 항목 생성
-> 같은 count를 읽을 수 있음
-> 같은 번호를 만들 수 있음
그래서 Firestore transaction으로 항목 문서와 counter 문서를 함께 다룬다.
transaction
-> 항목 문서 조회
-> 새 문서라면 counter 조회
-> nextSequence를 항목에 기록
-> counter.nextSequence 증가
-> 항목 setData
이 방식의 기준은 다음과 같다.
문서 생성 시에만 번호 부여
기존 문서 업데이트 시 번호 유지
번호 증가와 항목 생성을 같은 transaction에서 처리
즉 transaction은 여러 클라이언트가 동시에 문서를 생성할 때 순번 중복을 막을 수 있는 장치다.
nil과 시간 값은 Firestore 저장 형식에 맞춘다
Firestore에는 Swift의 nil이 그대로 저장되지 않는다.
optional 날짜 필드는 명시적으로 NSNull()로 저장할 수 있다.
targetDate == nil
-> Firestore에 null 저장

completedAt == nil
-> Firestore에 null 저장

removedAt == nil
-> Firestore에 null 저장
이렇게 하면 query에서 null 상태를 조건으로 사용할 수 있다.
마감일 없는 항목
-> where targetDate == null

삭제되지 않은 항목
-> where removedAt == null
서버 시간이 필요한 필드는 FieldValue.serverTimestamp()를 사용한다.
try await document.setData([
    "updatedAt": FieldValue.serverTimestamp()
], merge: true)
클라이언트 시간이 아니라 Firestore 서버 시간을 쓰면 여러 기기 사이의 시간 차이를 줄일 수 있다.
createdAt
updatedAt
deliveredAt
removedAt
archivedAt
이런 필드는 사용자 기기의 현재 시간이 아니라 서버가 기록한 시간을 기준으로 삼는 편이 안정적이다.
조회는 서버 쿼리와 클라이언트 필터를 나눈다
Firestore 쿼리는 where, order, limit, startAfter를 조합해서 만든다.
let snapshot = try await db.collection("items")
    .whereField("isDone", isEqualTo: false)
    .order(by: "updatedAt", descending: true)
    .limit(to: 20)
    .getDocuments()
주요 항목 조회도 같은 방식으로 구성할 수 있다.
삭제 여부
-> Firestore where

카테고리
-> Firestore where

완료 여부
-> Firestore where

마감일 유무
-> Firestore where

정렬 기준
-> Firestore order

페이지 크기
-> Firestore limit
페이지네이션은 마지막 문서의 정렬 값을 다음 조회의 시작 기준으로 사용한다.
마지막 문서
-> primary sort date
-> secondary sort date
-> documentID
-> 다음 조회의 startAfter
날짜 기반 정렬에서는 같은 날짜를 가진 문서가 함께 조회될 수 있으므로 documentID를 최종 정렬 기준으로 추가해 커서 페이지네이션의 기준을 고정한다.
order by updatedAt
order by documentID
검색어는 다른 기준이다.
Firestore가 처리하기 좋은 조건은 서버 쿼리로 보내고 텍스트 포함 여부처럼 앱 로직에 가까운 조건은 가져온 뒤 필터링한다.
서버 쿼리
-> 삭제 여부, 카테고리, 완료 여부, 날짜 범위, 정렬

클라이언트 필터
-> 제목/본문/태그 문자열 포함
-> 번호 검색
이 분리는 Firestore index와 검색 요구 사이의 균형이다.
모든 검색을 Firestore 조건으로 밀어 넣으려 하면 index와 쿼리 제약이 늘어난다.
반대로 모든 데이터를 가져와서 필터링하면 데이터가 많아질수록 비용과 지연이 커진다.
따라서 먼저 서버에서 줄일 수 있는 범위를 줄이고 남은 텍스트 조건을 클라이언트에서 처리한다.
데이터의 실시간 반영이 필요하면 listener를 사용한다
Firestore listener는 문서 변경을 실시간으로 받을 수 있다.
공식 문서의 흐름은 다음과 같다.
addSnapshotListener 등록
-> 최초 snapshot 수신
-> 문서 변경 시 snapshot 재수신
-> 더 이상 필요 없으면 listener 제거
단순 조회와 실시간 반영은 목적이 다르다.
한 번 읽어와서 페이지네이션이나 검색 조건에 맞춰 보여주면 되는 데이터는 getDocuments()로 충분하다.
화면에 머무는 동안 변경이 바로 반영되어야 하는 데이터는 addSnapshotListener를 사용한다.
읽지 않은 알림 수
-> badge와 tab 표시 상태에 직접 영향
-> addSnapshotListener 사용

최근 알림 목록
-> 사용자가 보는 동안 변경 반영 필요
-> addSnapshotListener 사용

일반 목록 조회
-> pagination과 검색 조건이 중요
-> getDocuments 사용
구독 결과는 Combine publisher로 감싼다.
Firestore listener
-> PassthroughSubject
-> AnyPublisher
-> 상태 구독 계층
취소 시점에는 listener를 제거한다.
publisher cancel
-> listener.remove()
이 구조는 Firestore listener의 생명주기를 클라이언트 구독 생명주기와 맞추기 위한 것이다.
Callable Functions는 클라이언트가 직접 처리하기 어려운 요청을 담당한다
Cloud Functions callable 공식 문서의 클라이언트 호출은 다음처럼 볼 수 있다.
let function = functions.httpsCallable("addMessage")
let result = try await function.call(["text": input])
서버에서는 onCall로 요청을 받는다.
export const addMessage = onCall(async (request) => {
    const text = request.data.text;
    const uid = request.auth?.uid;

    return { text, uid };
});
Callable Function의 중요한 특징은 Firebase Auth 사용자 정보가 요청에 포함된다는 점이다.
iOS Client
-> callable function
-> request.auth?.uid
다음 작업은 Callable Function으로 처리하기 적합하다.
외부 provider token 교환
외부 provider token 폐기
주요 항목 삭제 요청
주요 항목 삭제 취소
공통점은 클라이언트가 단순히 문서 하나를 바꾸는 것보다 서버 검증과 연쇄 작업이 필요하다는 점이다.
삭제 요청
-> 인증 사용자 확인
-> 대상 문서 존재 확인
-> 이미 삭제된 문서인지 확인
-> soft delete 상태 반영
-> 연결 문서 상태 동기화
-> 실패 시 가능한 범위에서 rollback
클라이언트에서 직접 삭제 상태 필드만 바꾸면 간단하다.
하지만 삭제와 연결된 문서가 여러 개라면 서버가 작업 단위를 가져야 한다.
항목 삭제
-> 항목 삭제 시각 기록
-> 연결된 알림 기록 삭제 상태 반영

알림 기록 삭제
-> 알림 기록 삭제 상태 반영

저장 항목 삭제
-> 저장 항목 삭제 상태 반영
Callable Function은 여기서 ‘사용자가 요청한 작업’의 서버 진입점이 된다.
Scheduled Functions는 주기적으로 실행될 작업을 담당한다.
Cloud Functions 공식 문서에서 scheduled function은 onSchedule로 작성한다.
export const cleanup = onSchedule("every day 00:00", async () => {
    // scheduled work
});
scheduled function은 크게 두 흐름에서 사용했다.
정기 발송 준비
-> 사용자 설정 시각에 맞춰 알림 작업을 큐에 넣음

정기 정리
-> soft delete 문서, 발송 기록, 축약 대상 문서 정리
알림 발송 준비는 단순히 하루에 한 번 실행하면 부족하다.
사용자마다 시간대와 발송 시각이 다를 수 있기 때문이다.
그래서 서버는 일정 주기마다 각 사용자 설정을 기반으로 현재 실행 시점이 발송 대상인지 계산한다.
every 5 minutes
-> 모든 사용자 조회
-> 사용자 설정 조회
-> 알림 허용 값 확인
-> 사용자 timeZone 기준 현재 시각 계산
-> 설정한 시각 범위인지 확인
-> 내일 마감 항목 조회
-> 항목별 task enqueue
여기서 scheduled function은 실제 푸시를 바로 보내지 않는다.
schedule function
-> 대상 계산
-> task queue 적재

task function
-> 최신 상태 재검증
-> 알림 기록 생성
-> FCM 발송
이 분리는 중요하다.
스케줄러가 대상 항목을 찾은 뒤 실제 발송되기 전까지 사용자가 항목을 수정할 수 있기 때문이다.
스케줄 시점
-> 항목 마감일이 내일

발송 시점
-> 항목이 완료됨
-> 마감일이 변경됨
-> 알림 설정이 꺼짐
따라서 task function에서 최신 Firestore 상태를 다시 확인한다.
Task Queue는 재시도 가능한 서버 작업 단위다
Cloud Functions task queue는 onTaskDispatched로 처리한다.
export const handleTask = onTaskDispatched(
    {
        retryConfig: { maxAttempts: 3 },
        rateLimits: { maxDispatchesPerSecond: 10 }
    },
    async (request) => {
        const data = request.data;
    }
);
task queue는 다음처럼 긴 작업을 작은 단위로 나누는 데 사용할 수 있다.
알림 발송
-> 스케줄러가 항목별 발송 task enqueue

카테고리 정리
-> 카테고리 변경 트리거가 제거된 카테고리별 정리 task enqueue
Task Queue를 쓰는 이유는 작업을 작게 나누기 위해서다.
스케줄러 하나가 모든 푸시를 직접 발송
-> 실패 범위가 커짐
-> 실행 시간이 길어짐
-> 재시도 단위가 큼

항목별 task로 분리
-> 실패한 task만 재시도
-> rate limit 설정 가능
-> payload 검증 위치 명확
알림 발송 task는 실행 전에 payload를 검증한다.
userId
itemId
targetDateKey
title
body
식별자에 /가 포함되면 Firestore 경로로 사용할 수 없으므로 거부한다.
payload 검증
-> Firestore 경로 안전성 확인
-> 필수 문자열 확인
그 다음 최신 문서를 다시 읽는다.
사용자 설정 문서
항목 문서
토큰 문서
읽지 않은 알림 수
그리고 발송 중복을 막기 위해 dispatch 문서를 먼저 생성한다.
recordId = itemId + targetDateKey

deliveryRecords/{recordId}
-> create 성공
-> 아직 발송하지 않은 조합

create already-exists
-> 이미 처리한 조합
-> 발송 중단
여기서 set이 아니라 create를 쓰는 이유는 같은 작업이 다시 실행돼도 중복 발송을 막기 위해서다.
같은 task가 재시도되거나 같은 항목이 다시 큐에 들어와도 같은 dispatch 문서가 이미 있으면 중복 발송을 막을 수 있다.
Firestore Trigger는 데이터 변화의 후처리를 담당한다
Cloud Functions는 Firestore 문서 변경을 trigger로 받을 수 있다.
export const onItemChanged = onDocumentUpdated(
    "members/{uid}/items/{itemId}",
    async (event) => {
        const before = event.data?.before.data();
        const after = event.data?.after.data();
    }
);
다음 변화에는 Firestore trigger를 둘 수 있다.
항목 문서 삭제
-> 연결된 알림 기록과 발송 기록 삭제

항목 문서 업데이트
-> 지난 마감 항목이 완료되면 발송 기록 정리

카테고리 설정 업데이트
-> 제거된 사용자 카테고리를 쓰던 항목을 기본 카테고리로 이동
이 작업들은 사용자의 직접 요청 흐름에 넣기 애매하다.
예를 들어 사용자가 카테고리 설정을 바꾸는 순간 그 카테고리를 쓰던 모든 항목을 즉시 클라이언트에서 찾아 수정하게 만들 수 있다.
하지만 이 방식은 다음 문제가 있다.
클라이언트가 많은 문서를 읽고 써야 함
클라이언트가 종료되면 후처리가 중단될 수 있음
여러 기기에서 같은 정리 작업이 중복될 수 있음
서버 trigger로 옮기면 기준이 바뀐다.
카테고리 문서 변경
-> 서버가 before/after 비교
-> 제거된 카테고리 id 계산
-> task queue로 정리 작업 분리
-> 해당 카테고리 항목을 기본 카테고리로 update
즉 Firestore trigger는 “문서 변화 이후 반드시 따라와야 하는 보정 작업”에 적합하다.
Auth Trigger는 계정 삭제의 마지막 정리 지점이다
사용자가 계정을 삭제하면 Firebase Auth 사용자도 삭제된다.
그 뒤 Firestore에 남아 있는 사용자 루트 문서를 정리해야 한다.
이 경우 Auth delete trigger를 사용할 수 있다.
Firebase Auth user deleted
-> members/{uid} 문서 참조
-> recursiveDelete
-> 사용자 하위 데이터 정리
이 작업은 클라이언트에서 처리하기 어렵다.
계정 삭제 이후에는 클라이언트가 더 이상 같은 인증 상태로 Firestore 하위 문서를 안전하게 정리할 수 없기 때문이다.
클라이언트 계정 삭제 요청
-> Auth 사용자 삭제
-> Auth trigger
-> Firestore 사용자 데이터 정리
계정 삭제는 Auth가 기준 이벤트이고 Firestore 정리는 그 이벤트의 후처리다.
FCM은 토큰 저장과 발송을 분리한다
Firebase Cloud Messaging 공식 문서에서는 iOS에서 APNs token을 Messaging에 전달하는 흐름을 보여준다.
func application(
    _ application: UIApplication,
    didRegisterForRemoteNotificationsWithDeviceToken deviceToken: Data
) {
    Messaging.messaging().apnsToken = deviceToken
}
FCM registration token이 갱신되면 delegate에서 받을 수 있다.
func messaging(
    _ messaging: Messaging,
    didReceiveRegistrationToken fcmToken: String?
) {
    // send token to server
}
token 갱신은 바로 Firestore 쓰기로 연결하지 않고 클라이언트 내부 이벤트로 넘길 수 있다.
Messaging delegate
-> FCM token 갱신 이벤트 발행
-> 토큰 동기화 핸들러
-> members/{uid}/profiles/secrets의 token 필드 갱신
로그아웃할 때는 token을 제거한다.
signOut
-> Firestore token 필드 삭제
-> Messaging token 삭제
-> Firebase Auth signOut
이렇게 해야 이전 사용자의 기기로 새 사용자의 알림이 섞이는 위험을 줄일 수 있다.
푸시 발송은 서버에서 처리한다.
task function
-> token 문서 조회
-> unread count 조회
-> notification payload 구성
-> APNs badge 포함
-> admin.messaging().send(message)
알림 기록은 Firestore에 먼저 저장한다.
Firestore notification document 생성
-> FCM token 없으면 푸시 발송 생략
-> 기록은 유지
즉 푸시 발송 성공 여부와 서비스 내부 알림 기록 생성은 완전히 다르다.
알림 기록
-> 서비스 안에서 확인 가능한 서버 상태

FCM 발송
-> 사용자 기기로 전달하는 외부 채널
FCM token이 없거나 발송에 실패해도 기록 문서를 남기면 사용자는 클라이언트에 진입했을 때 알림 기록을 확인할 수 있다.
Firebase Admin SDK는 서버 권한으로만 가능한 작업을 담당한다
Cloud Functions 내부에서는 Firebase Admin SDK를 사용한다.
admin.auth()
-> 사용자 조회/생성
-> custom token 생성

admin.firestore()
-> 사용자 하위 문서 읽기/쓰기
-> batch
-> collectionGroup
-> recursiveDelete

admin.messaging()
-> FCM 발송
Admin SDK는 보안 규칙을 통과하는 클라이언트 SDK와 다르다.
서버 권한으로 실행되기 때문에 입력 검증을 함수 안에서 직접 해야 한다.
request.auth?.uid 확인
필수 payload 확인
문서 존재 여부 확인
이미 처리된 작업인지 확인
사용자 입력으로 Firestore path가 깨지지 않는지 확인
Callable Function에서 request.auth를 확인하지 않으면 서버 권한 코드가 인증되지 않은 요청으로 실행될 수 있다.
따라서 함수마다 다음 기준을 둔다.
사용자 데이터 접근
-> request.auth?.uid 필수

provider token 교환
-> authorization code 필수
-> 환경 변수 secret 필수

삭제/복구 요청
-> 대상 id 필수
-> 대상 문서 존재 확인
Firebase Admin SDK는 강력하지만 그만큼 함수 내부 검증이 클라이언트 guard보다 더 중요하다.
Firebase 구성 흐름 다시 보기
사용한 Firebase 요소를 기능 흐름 기준으로 정리하면 다음과 같다.
| Firebase 요소 | 사용한 위치 |
|---|---|
| Firebase Core | 앱 시작 시 SDK 초기화 |
| Firebase Auth | 로그인 상태, provider 연결, 사용자 uid 기준 제공 |
| Cloud Firestore | 사용자 데이터, 설정, 항목, 알림 기록, 토큰, 카운터 저장 |
| Cloud Functions callable | 인증 보조, 삭제/복구 요청, provider token revoke |
| Cloud Functions scheduler | 알림 대상 계산, soft delete 정리, 발송 기록 정리 |
| Cloud Functions Firestore trigger | 문서 변경 후처리, 연결 데이터 정리 |
| Cloud Functions Auth trigger | 계정 삭제 후 사용자 하위 데이터 정리 |
| Cloud Tasks | 발송/정리 작업을 재시도 가능한 단위로 분리 |
| Firebase Admin SDK | 서버 권한 사용자/문서/메시지 처리 |
| Firebase Cloud Messaging | APNs 연동, FCM token 관리, 푸시 발송 |
기능 흐름으로 다시 보면 다음과 같다.
로그인
-> Auth
-> Callable Functions
-> Admin Auth
-> Firestore 사용자 기본 문서 초기화
-> FCM token 저장

항목 생성/수정
-> Firestore
-> transaction으로 번호와 문서 동시 처리

항목 삭제
-> Callable Function
-> 대상 문서 확인
-> 연결 알림 기록 상태 변경

알림 발송
-> scheduled function
-> Cloud Tasks
-> task function
-> Firestore 최신 상태 재검증
-> 알림 기록 생성
-> FCM 발송

카테고리 변경
-> Firestore trigger
-> Cloud Tasks
-> 관련 항목 batch update

계정 삭제
-> Auth user delete
-> Auth trigger
-> Firestore recursive delete
정리
Firebase를 사용할 때 처음에는 각 제품을 기능 단위로 생각하기 쉽다.
Auth
-> 로그인

Firestore
-> 데이터 저장

Functions
-> 서버 코드

FCM
-> 푸시 알림
하지만 기능이 늘어나면 제품 이름보다 처리 위치를 먼저 고민하게 된다.
클라이언트가 바로 쓸 수 있는 데이터인가?
서버 권한이 필요한 작업인가?
사용자 액션과 분리되어 나중에 실행되어야 하는가?
중복 실행되어도 안전해야 하는가?
클라이언트가 종료되어도 완료되어야 하는가?
이 질문에 따라 Firebase를 사용하는 방식도 달라진다.
즉시 조회/수정 가능한 사용자 데이터
-> Firestore client SDK

provider secret, token revoke, custom token 발급
-> Callable Functions + Admin SDK

삭제/복구처럼 연결 데이터 보정이 필요한 요청
-> Callable Functions

주기 실행 작업
-> Scheduled Functions

재시도 가능한 작은 작업 단위
-> Cloud Tasks

문서 변경 후처리
-> Firestore Trigger

기기 푸시 전달
-> FCM
정리하면 다음과 같다.
Firebase를 쓴다고 서버에서 할 일이 사라지는 것은 아니다.

다만 직접 서버를 운영하지 않아도
Auth, Firestore, Cloud Functions, FCM을 조합해
필요한 서버 기능을 구성할 수 있다.

이때 중요했던 것은 Firebase 제품을 많이 붙이는 것이 아니라
각 기능이 어떤 실행 위치에 있어야 하는지 정하는 일이었다.

즉시 처리할 수 있는 데이터 작업은 Firestore client SDK에 두고
인증 검증, 연결 문서 보정, 외부 token 처리는 Callable Functions로 옮겼다.

정해진 주기로 반복되어야 하는 작업은 Scheduled Functions에 두고
실패 시 다시 실행될 수 있는 작업은 Cloud Tasks로 나누었다.
참고 문서
- Add Firebase to your Apple project | Firebase
- Authenticate Using Google Sign-In on Apple Platforms | Firebase Authentication
- Authenticate Using Apple | Firebase Authentication
- Get data with Cloud Firestore | Firebase
- Call functions from your app | Cloud Functions for Firebase
- Schedule functions | Cloud Functions for Firebase
- tasks namespace | Cloud Functions for Firebase
- Receive messages in Apple platform apps | Firebase Cloud Messaging