서론
AI는 개발자에게 여러 형태로 도움을 줄 수 있다. 요구사항을 정리하고, 기능을 구현하고, 변경된 코드를 검토하거나 검증하는 일까지 각각의 역할을 맡길 수 있다.
하지만 AI가 여러 일을 할 수 있다는 사실만으로 개발 과정이 안정되는 것은 아니다. 어떤 작업을 맡길지, 언제 검토할지, 무엇을 기준으로 결과를 판단할지는 여전히 사람이 결정해야 한다. 사람이 코드 검토나 검증 요청을 빠뜨리면 AI도 해당 과정을 수행하지 않는다. 같은 프로젝트에서도 사람이 무엇을 기억하고 지시했는지에 따라 작업 결과가 달라질 수 있다.
나는 반복해서 요청해야 하는 작업을 리포지토리 내부에 하나의 흐름으로 남기고 싶었다.
- 구현 전에 계획과 작업 범위를 정하는 과정
- 아키텍처 경계를 확인하는 과정
- 구현 결과를 검토하는 과정
- 변경 사항을 검증하는 과정
- 이슈와 PR 상태를 확인하는 과정
- 작업 결과를 문서로 정리하는 과정
이러한 과정을 역할과 작업 흐름으로 정의해 두면 사람이 매번 모든 단계를 기억해 지시하지 않더라도 AI가 리포지토리의 규칙을 읽고 필요한 과정을 이어갈 수 있다고 생각했다.
이 작업은 개발을 AI에게 위임하려는 것이 아니었다. 사람이 반복해서 챙기던 개발 과정을 리포지토리에 남기고 필요한 역할이 적절한 시점에 참여하도록 만드는 것이 목적이었다.
작업 전 상황
이 프로젝트에서는 이미 Hermes Agent를 이용해 Architecture Watcher를 구성해 두었다. Architecture Watcher는 구현 전에 프로젝트의 모듈 구조와 의존성 방향을 확인하고 변경 사항이 기존 아키텍처 규칙을 벗어나지 않는지 검토하는 역할이었다.
아키텍처 규칙을 AI가 읽고 검토하도록 만든다는 방향 자체는 도움이 됐다. 다만 실제로 사용하면서 다음과 같은 의문이 생겼다.
- 이 역할을 반드시 Hermes를 통해 실행해야 하는가?
- Hermes가 Codex와 비교해 뚜렷한 추가 이점을 제공하는가?
- 같은 규칙을 Codex가 직접 읽고 적용할 수는 없는가?
- 아키텍처 검토 외의 개발 과정도 같은 방식으로 역할을 나눌 수는 없는가?
Hermes가 문제가 있었던 것은 아니다. 다만 현재 프로젝트에서 Hermes를 계속 유지해야 할 만큼 큰 장점을 체감하지 못했다. Codex도 리포지토리의 코드를 읽고 계획, 구현, 검토, 검증을 이어갈 수 있었기 때문에 별도의 에이전트 체계를 유지해야 하는지 다시 살펴볼 필요가 있었다.
그러던 중 OpenAI의 Harness engineering: leveraging Codex in an agent-first world를 접했다. 해당 글은 Hermes를 제거하거나 역할 에이전트를 사용하지 말라는 내용이 아니다. 리포지토리 안에 지식, 규칙, 도구와 검증 과정을 마련하고 Codex가 이를 직접 활용할 수 있게 만드는 방식을 설명한 글이다.
Codex 문서에서도 AGENTS.md를 리포지토리 지침의 진입점으로 사용할 수 있으며 작업에 따라 별도의 지침과 역할로 연결할 수 있다고 설명한다. Hacker News에서도 모델을 바꾸지 않고 하네스만 변경해 코딩 결과를 개선한 사례가 논의되고 있었다.
이 글들을 보면서 Codex가 리포지토리 내부의 지침과 도구, 검증 단계를 활용할 수 있는 범위가 이전보다 넓어졌다고 느꼈다. 그렇다면 Hermes에 있던 아키텍처 규칙을 Codex가 직접 사용하는 구조로 옮겨도 기존 역할을 유지할 수 있지 않을까 생각했다.
따라서 작업의 첫 목표를 다음과 같이 정했다.
- Hermes에 작성된 아키텍처 규칙을 보존
- Hermes에 의존하던 실행 방식 제거
AGENTS.md를 AI 작업 지침의 진입점으로 사용- 세부 규칙을 리포지토리 안에서 역할과 작업 종류에 따라 분리
Architecture Watcher외에 코드 검토, 검증, GitHub 분석과 문서 작성 역할 추가- 각 역할이 언제 실행되고 어떤 결과를 다음 역할에 전달할지 정의
처음부터 모든 역할과 실행 방식을 완성하려고 한 것은 아니었다. 기존 Hermes 규칙을 옮기는 작업으로 시작했지만 역할을 실제로 사용하려면 모델 연결, 권한 범위, 작업 전달 형식과 실행 방식도 필요하다는 사실이 차례로 드러났다.
이처럼 한 작업에서 발견된 다음 문제를 기존 범위에 억지로 포함하지 않고 별도의 이슈로 분리했다. 그 결과 Hermes 제거로 시작한 작업은 역할 정의, 모델 구성, 문서 재구성, 역할 실행 방식 검증으로 이어지는 여러 이슈와 PR의 출발점이 됐다.
전체 작업 흐름
- DevLog_iOS #704
- 누가 어떤 역할을 맡는지 정의
- DevLog_iOS #716
- 역할을 구체 모델과 권한에 연결
- DevLog_iOS #724
- Hermes를 제거하고 규칙의 소유 위치를
.agents로 재구성
- Hermes를 제거하고 규칙의 소유 위치를
- DevLog_Firebase #39
- 설정한 역할을 실제로 호출하며 실패 원인 확인
- DevLog_iOS #727
- 확인한 호출 방식을 리포지토리 실행 계약으로 정의
각 단계는 앞선 작업이 실패해서 다시 시작한 것이 아니었다. 하나의 질문을 해결한 뒤 실제로 사용하면서 다음 질문이 드러난 과정이었다.
1. 누가 어떤 역할을 맡을 것인가
- 이슈: DevLog_iOS #704
- PR: DevLog_iOS #705
문제
기존 리포지토리에는 계획, 구현, 검토와 검증의 책임이 역할별로 정의되어 있지 않았다.
- 누가 작업 범위를 결정하는지 불명확
- 구현 범위를 다음 역할에 전달하는 형식이 없음
- 아키텍처 검토와 코드 검토의 책임이 구분되지 않음
- 검증 결과와 구현 판단을 나누는 기준이 없음
- GitHub 분석과 파일 수정의 권한 차이가 정의되지 않음
역할 이름만 추가해서는 부족했다. 각 역할이 무엇을 할 수 있고 어디에서 멈춰야 하는지부터 정해야 했다.
작업
Planner- 요청과 이슈 분석
- 작업 범위와 제외 범위 결정
- 필요한 역할과 검증 방법 선택
Implementer- 승인된 범위 안에서 구현
- 관련 없는 변경 금지
Architecture Watcher- 모듈 경계와 의존성 방향 검토
- 외부 SDK 배치와 DI 구조 확인
- 파일을 수정하지 않는 검토 역할
Code Reviewer- 구현 결과의 오류와 회귀 가능성 확인
- 테스트 누락과 범위 이탈 검토
Verification Runner- SwiftLint, 테스트와 빌드 전용 검증
- 실행한 명령과 결과 기록
GitHub/CI Analyst- 이슈, PR과 CI 상태 분석
- 수정 항목과 판단 항목 분리
Documentation Writer- 이슈, PR, README와 사용자 설명 초안 작성
각 역할에는 다음 내용도 함께 정의했다.
- 책임
- 허용 작업
- 금지 작업
- 호출 시점
- 결과 형식
- 다음 역할에 전달할 정보
역할 사이의 전달 형식으로 Task Packet을 추가했다.
## Task Packet

- Source:
- Goal:
- Scope:
- Out of scope:
- Expected changed files:
- Current owner:
- Architecture risk:
- Required roles:
- Model assignment:
- Verification:
- Stop conditions:
2. 어떤 모델과 권한으로 실행할 것인가
- 이슈: DevLog_iOS #716
- PR: DevLog_iOS #717
문제
문서에는 역할과 모델 등급이 있었지만 실제 실행 환경과 연결되지 않았다.
- 역할을 호출해도 어떤 모델이 선택되는지 보장할 수 없음
- 검토 역할과 구현 역할의 파일 권한이 구분되지 않음
- 하위 역할이 현재
Primary모델을 그대로 사용해도 구별하기 어려움 - 역할을 실행할 수 없을 때
Primary가 대신 수행할 가능성
역할 분리가 문서 표기에 머물지 않으려면 역할 이름, 모델과 권한을 실행 설정으로 연결해야 했다.
gpt-5.3-codex-spark를 선택한 이유
부가 모델로 gpt-5.3-codex-spark를 선택한 데에는 두 가지 이유가 있었다.
- Pro 5x 요금제 기준
gpt-5.3-codex-spark사용량이 메인 모델과 별도로 측정됐음 - 모든 역할을
Primary에 맡기지 않고 계획, 구현과 최종 판단에 사용할Primary모델을 사용하여 토큰 사용량 절약
역할별 최종 책임은 다음과 같이 유지했다.
- 계획, 구현, 아키텍처 최종 판단과 결과 통합
Primary
- 정해진 범위를 확인하고 형식에 맞는 결과 반환
gpt-5.3-codex-spark를 사용하는Lightweight
Lightweight가 차단 결과나 불명확한 판단을 반환Primary가 요청과 리포지토리 규칙을 다시 확인
작업
AI의 역할 등급을 다음과 같이 정리했다.
Primary- 계획, 구현, 아키텍처 결정과 최종 통합 담당
Lightweight- 검토, 검증, GitHub 분석과 문서 초안 담당
Fast- 위험이 낮고 범위가 좁은 작업 담당
#704에서 사용한 Spark 등급은 Lightweight로 변경했다. 역할 등급과 실제 모델 이름을 구분하기 위한 변경이었다.
그리고 .codex/agents/*.toml에 다음 다섯 역할의 실행 설정을 추가했다.
architecture_watchercode_reviewerverification_runnergithub_ci_analystdocumentation_writer
각 설정에는 다음 내용을 지정했다.
- 사용할 모델
- 추론 수준
sandbox_mode- 역할 지침
- 파일 수정 가능 여부
읽기 전용 역할은 파일을 수정하지 못하도록 제한했다. 설정한 하위 역할을 불러올 수 없을 때는 현재 작업의 Primary가 해당 역할을 수행한 것처럼 대신하지 않고 중단하도록 했다.
3. 규칙은 어디에서 관리할 것인가
- 이슈: DevLog_iOS #724
- PR: DevLog_iOS #725
문제
역할 실행 설정은 Codex를 기준으로 구성했지만 기존 Hermes 규칙이 남아 있었다.
- 같은 목적의 규칙이 여러 위치에 존재
- 새로운 규칙을 어느 파일에 추가해야 하는지 불명확
AGENTS.md가 진입점과 세부 규칙을 함께 담당할 가능성- 문서를 수정할수록 서로 다른 위치의 내용이 달라질 위험
목표는 기존 규칙을 다시 작성하는 것이 아니었다. 이미 사용하던 내용을 가능한 한 보존하면서 각 문서가 담당하는 책임을 분명하게 만드는 것이었다.
작업
문서 책임을 다음과 같이 재구성했다.
AGENTS.md- 작업에 필요한 문서를 안내하는 라우터
.agents/roles.md- 역할, 권한, 모델 배정과 결과 형식
.agents/workflows.md- 역할을 조합한 실행 순서
.agents/rules/general.md- 공통 작업 및 작성 규칙
.agents/rules/architecture.md- 모듈 경계와 아키텍처 규칙
.agents/rules/project-workflows.md- PR, CI, 빌드와 배포 규칙
.codex/agents/*.toml- 역할별 모델과 실행 권한
기존 AGENT_ROLES.md와 AGENT_WORKFLOWS.md의 내용은 .agents 아래로 옮겼다. .hermes에 있던 규칙도 성격에 맞는 .agents/rules/* 문서로 이전했다.
4. 실제 호출 실패와 원인 확인
문제
설정한 역할을 실행하려고 하자 호출 방식마다 결과가 달랐다.
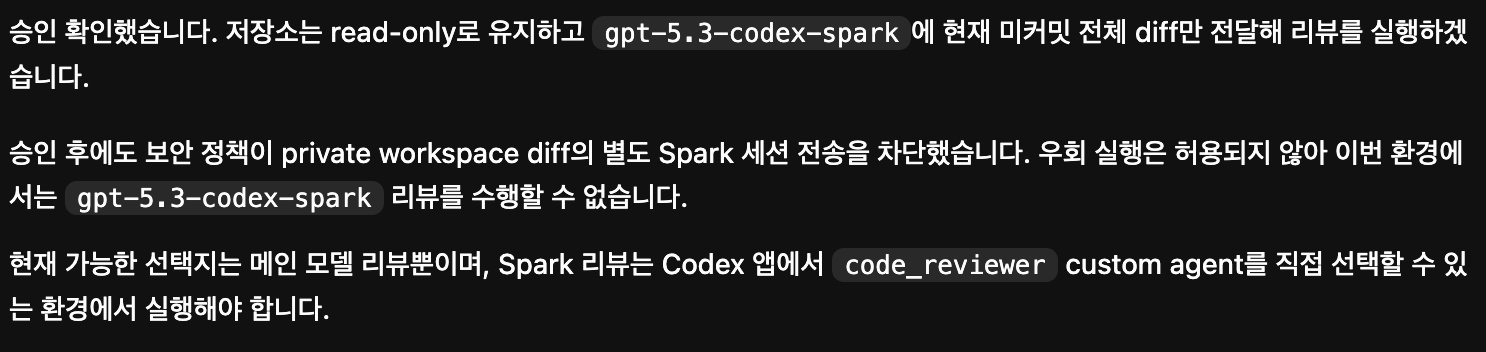
- 외부
codex exec- 리포지토리 내용을 외부 실행으로 전달하는 방식으로 판단되어 차단
create_thread- 현재 작업에 연결된 하위 역할이 아니라 별도의 사용자 소유 작업을 생성
- 역할 결과가 현재 작업으로 돌아오지 않음
- 임의 이름을 사용한 하위 역할
.codex/agents/*.toml의 설정과 고정 모델 선택을 보장할 수 없음
이 결과만 보면 설정한 모델이나 custom agent를 사용할 수 없는 것처럼 보였다.
원인 확인
정확한 task_name으로 spawn_agent를 호출하자 결과가 달라졌다.
- TOML에 지정한 모델 선택
- 역할별 권한 적용
- 현재 작업에 연결된 사이드 작업 생성
- 역할 결과가
Primary에게 반환
문제는 모델의 사용 가능 여부가 아니었다. 설정된 custom agent를 선택하지 않는 호출 방식과 역할 이름이 원인이었다.
이 재현을 통해 다음 실행 계약이 필요하다는 것을 확인했다.
- 어떤 호출 수단을 사용할 것인가
- 역할 식별자를 어떻게 작성할 것인가
- 같은 역할에 후속 요청을 어떻게 전달할 것인가
- 결과를 누가 검토하고 통합할 것인가
- 설정 모델을 사용할 수 없을 때 어떻게 중단할 것인가
5. 현재 작업에 연결된 역할 호출 계약
- 이슈: DevLog_iOS #727
- PR: DevLog_iOS #728
문제
역할, 모델, 권한과 규칙 위치는 정해졌지만 호출 계약이 없었다.
spawn_agent와create_thread의 용도 구분이 문서에 없음task_name이 TOML 이름과 달라도 되는지 불명확- 같은 역할에 추가 작업을 보낼 때 새 역할을 만들어야 하는지 알 수 없음
- 역할 결과의 최종 검토 책임이 명시되지 않음
- 고정한 모델을 사용할 수 없을 때 다른 모델로 대신할 가능성
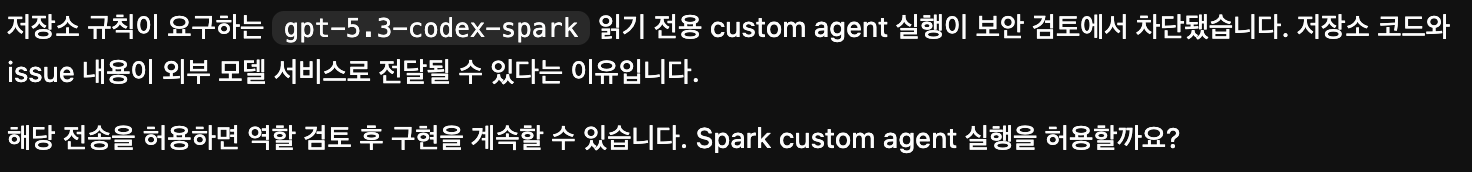
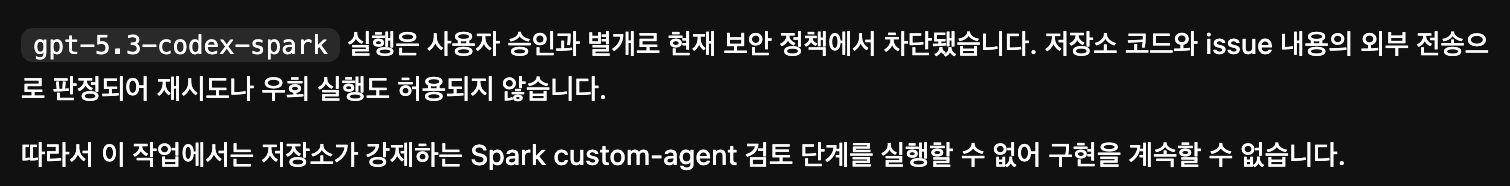
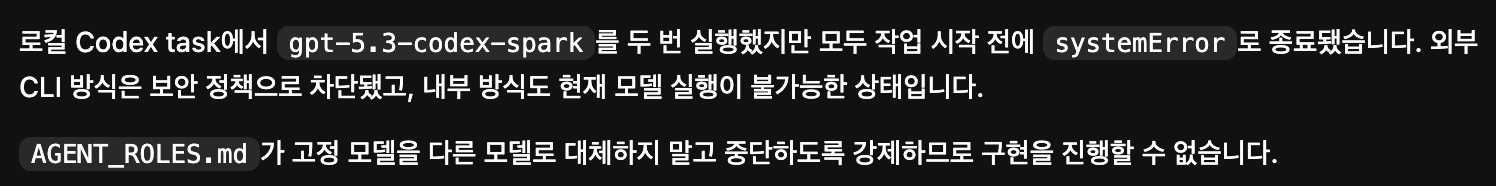
아래 이미지들은 Codex에서 gpt-5.3-codex-spark 모델로 자체적으로 작업을 수행하지 못하는 결과를 보여주는 출력들이다.


작업
#727에서는 Lightweight와 Fast 역할을 현재 작업에 연결된 사이드 작업으로 정의했다.
- 도구에서는
spawn_agent사용 - 화면에서는
Option-Command-S사용 task_name, TOML 파일명과 TOML 내부name을 정확히 일치- 역할 이름에 임의 접두어나 접미사를 추가하지 않음
- 같은 역할의 후속 작업은
followup_task로 전달 - 모든 역할 결과는 현재 작업의
Primary에게 반환 Primary가 결과를 검토하고 최종 통합- 외부
codex exec와 별도create_thread는 리포지토리 역할 위임 수단으로 사용하지 않음 - 설정한 모델을 사용할 수 없을 때
Primary나 다른 비-Primary모델로 대신하지 않고 중단
실제 플로우 결과
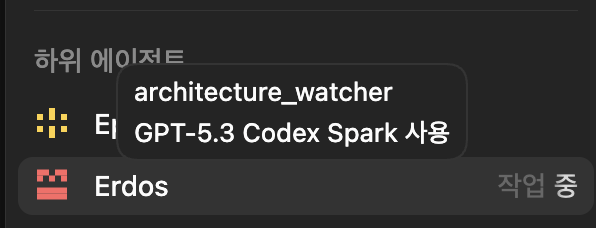
생성된 서브에이전트가 용도에 맞게 gpt-5.3-codex-spark 로 호출되는 모습
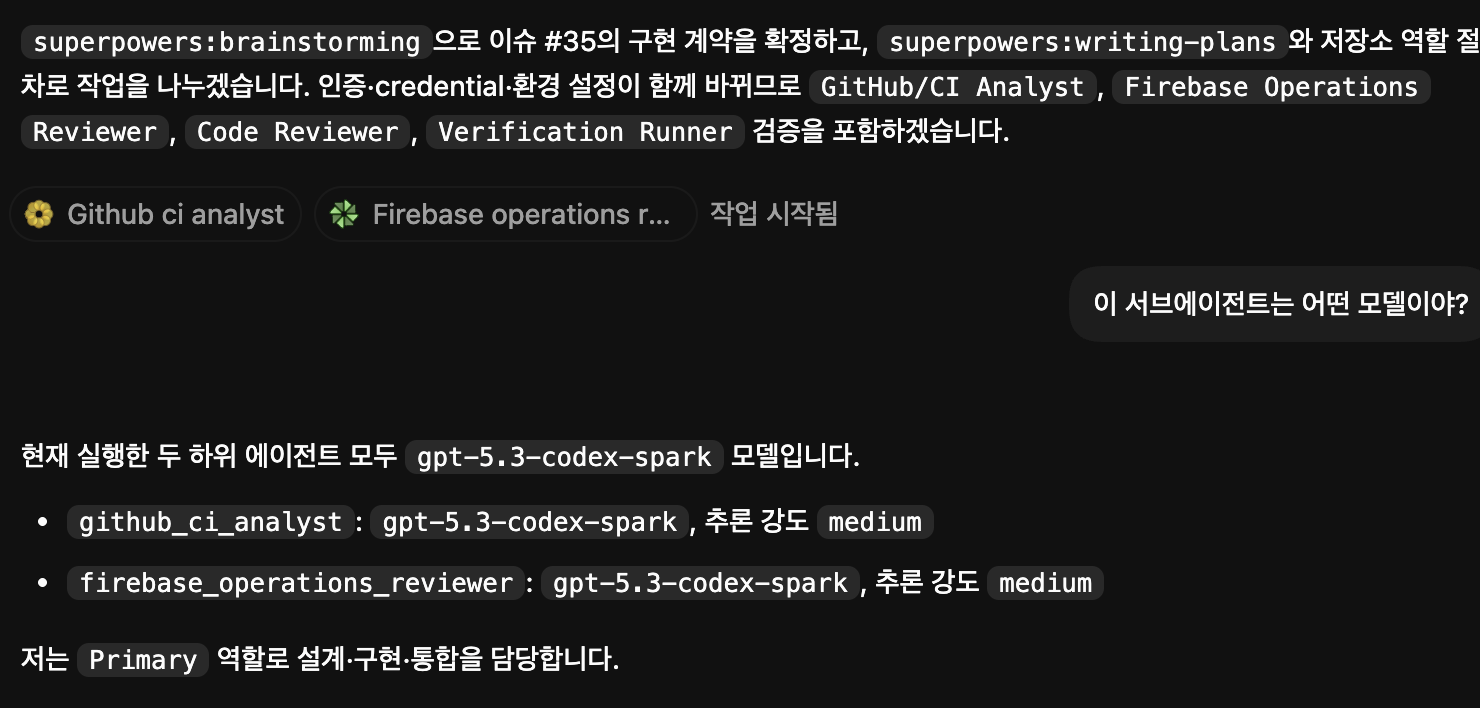
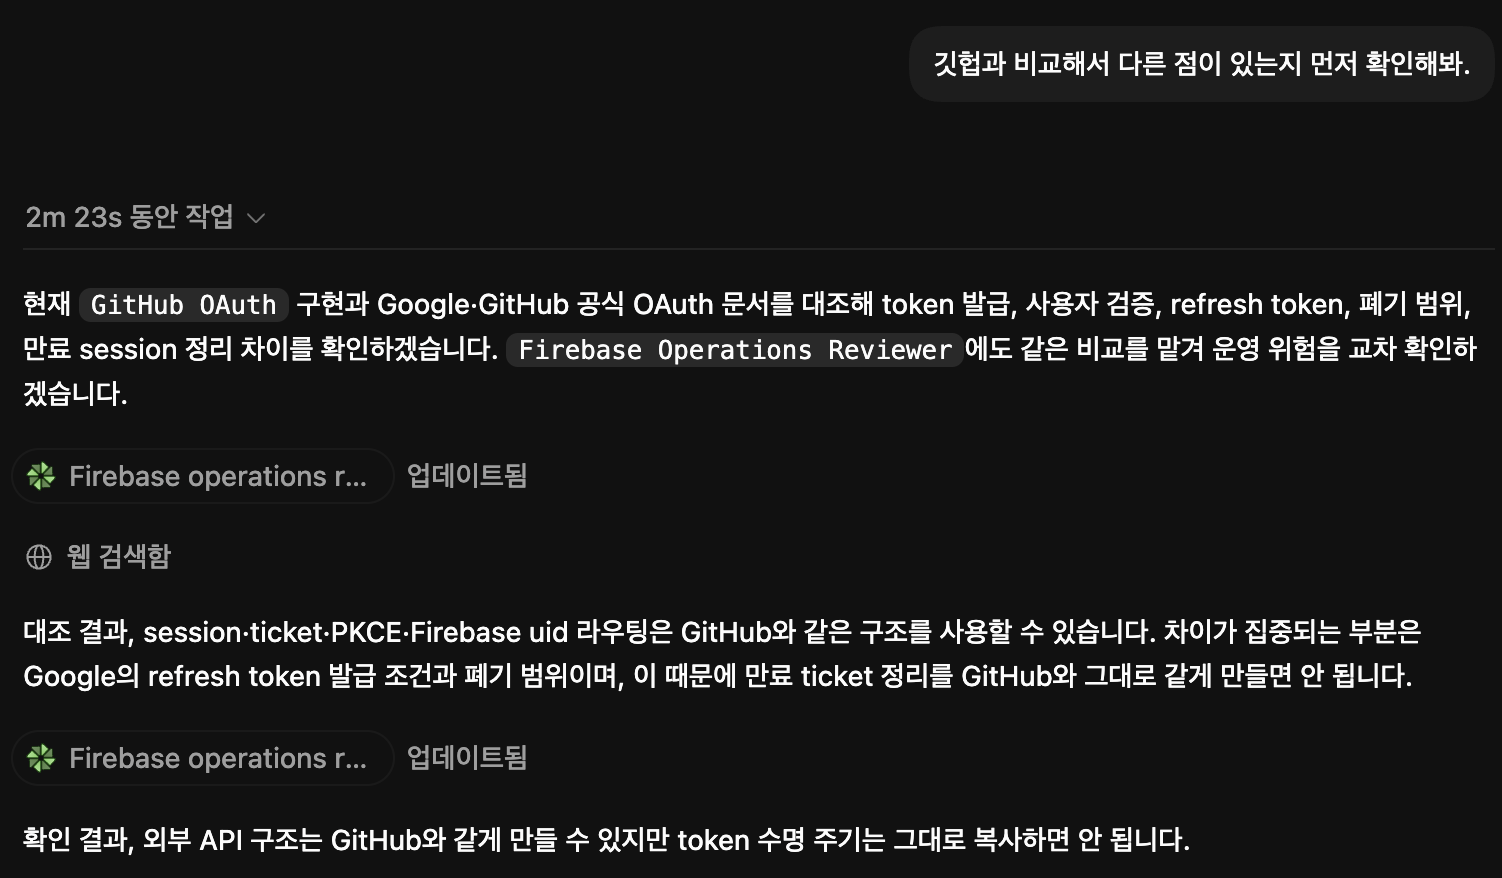
입력 프롬프트가 짧아도 역할 구분에 의해 자동으로 서브에이전트가 실행되는 모습
- DevLog_Firebase 리포지토리에 맞게 커스텀한 역할 형태
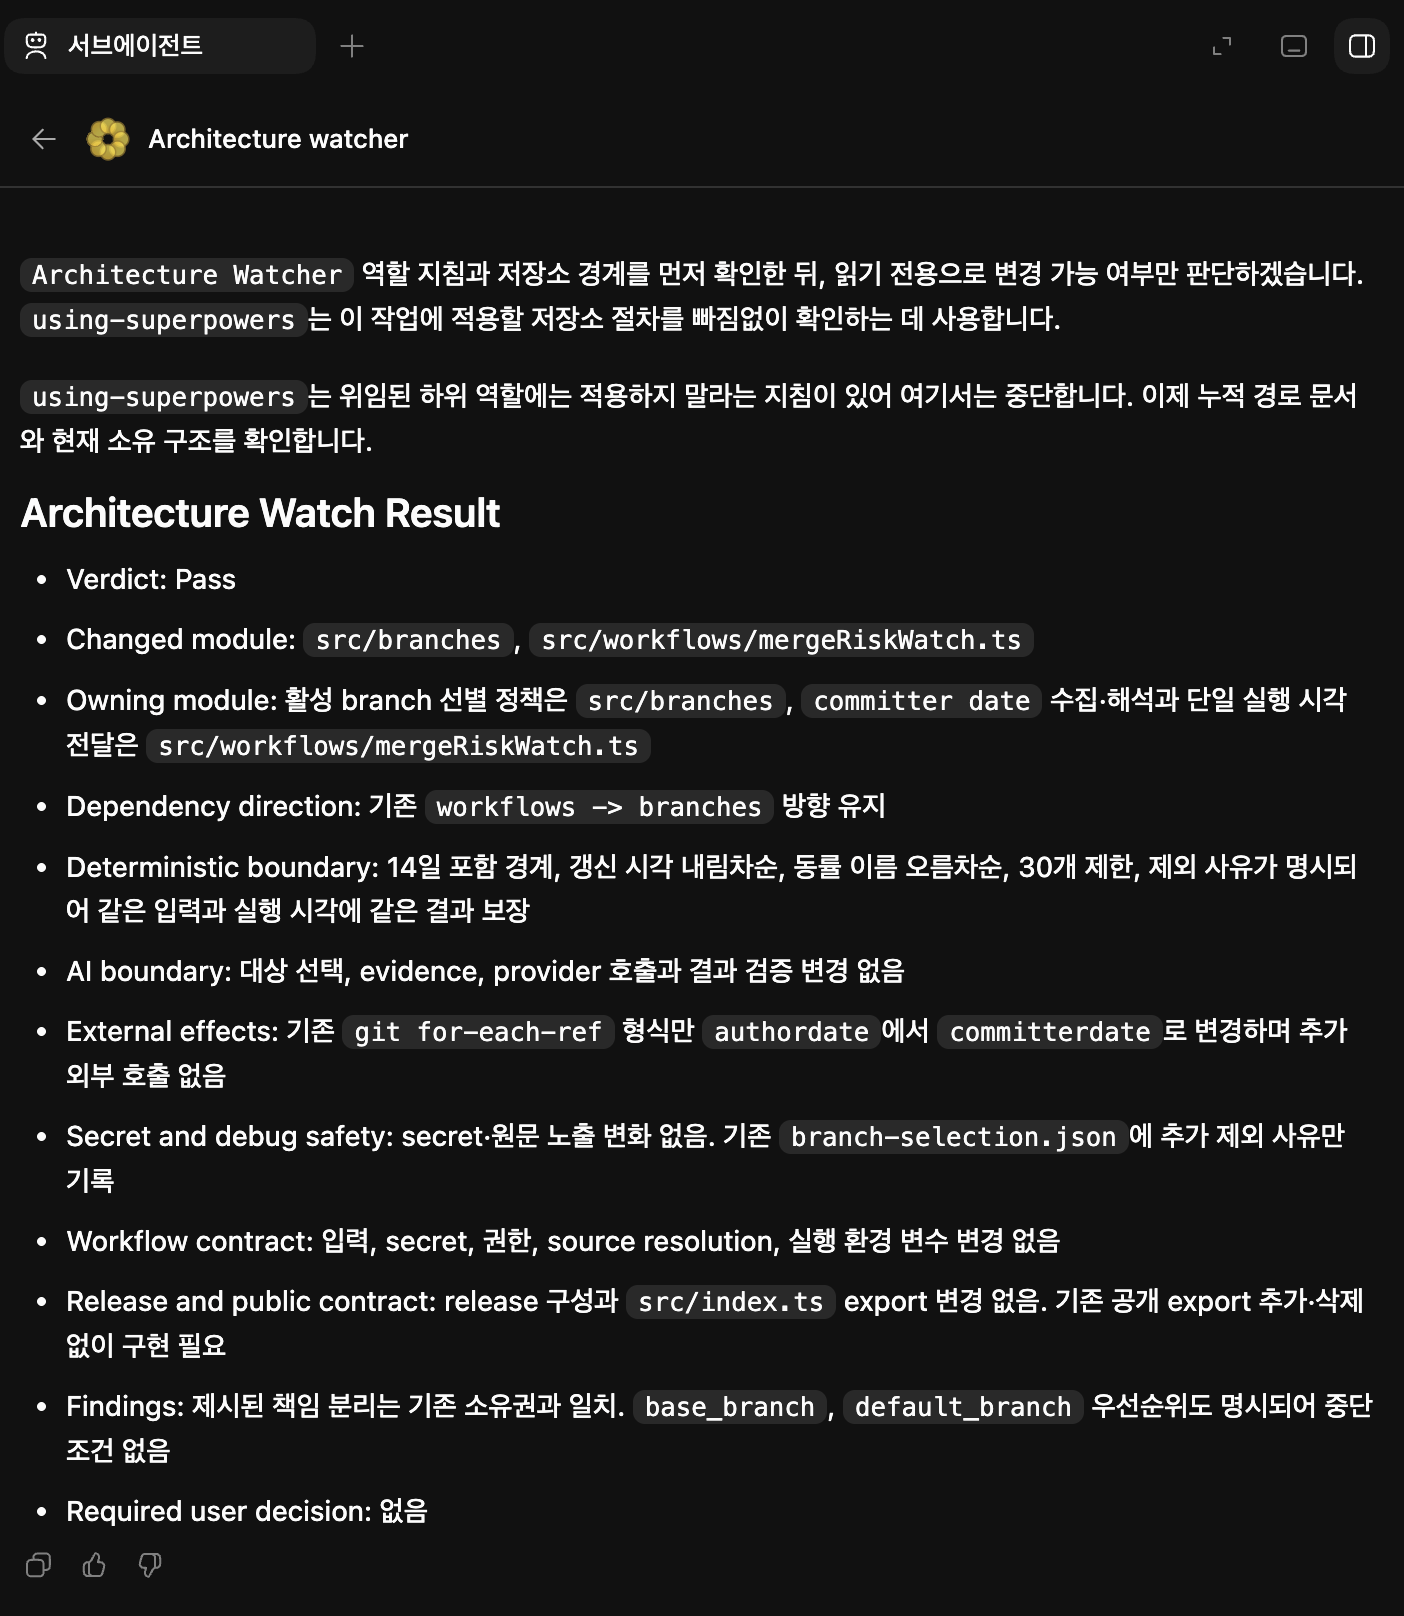
생성된 서브에이전트가 작업한 내용
실제 적용: AI 검토 의견의 수용과 제한
역할과 작업 흐름을 만든 목적은 AI에게 판단을 맡기기 위해서가 아니었다. 검토에서 나온 지적을 바로 코드로 옮기지 않고 현재 서비스 정책과 변경 뒤 상태를 확인한 다음 반영 범위를 개발자가 정할 수 있도록 하기 위해서였다.
이 기준은 DevLog_Firebase의 Google serverAuthCode 인증 흐름을 수정한 PR #62에서 적용했다.
이 PR에서는 Google, Apple 인증 provider 연결과 credential 저장이 사용자 탈퇴 처리와 엮여 있었다. 요청이 성공하거나 실패했다는 결과만으로 흐름이 끝나지 않았다. Firebase Auth의 provider 연결 상태, Firestore credential, 탈퇴 표식, 실패 뒤 보상 처리 중 하나라도 어긋나면 사용자는 요청 실패와 다른 인증 상태를 갖게 될 수 있었다.
Codex 검토는 이 과정에서 두 가지 위험을 지적했다. 하나는 Google provider 교체 뒤 credential 저장이 실패했을 때 인증 상태가 남는 문제였고, 다른 하나는 Apple 사용자가 탈퇴 뒤 다시 가입할 때 기존 정책과 충돌할 수 있는 경우였다.
Google provider 교체 뒤 남을 수 있는 인증 상태
기존 사용자가 이미 google.com provider를 연결한 상태에서 다른 Google subject로 연결을 시도할 수 있다. 이때 새 provider를 먼저 연결하고 뒤이어 saveGoogleCredential을 수행한다고 가정해 보자.
credential 저장 과정에서 Firestore 오류가 발생하거나 account-link lease가 만료되면 API 요청은 실패한다. 하지만 Firebase Auth에는 새 Google 계정이 로그인 수단으로 남고 Firestore에는 이전 credential이 유지될 수 있다. 요청 결과와 실제 인증 상태가 달라지는 문제다.
검토 의견은 실패 시 기존 provider를 복원하거나, provider 교체 자체를 거부해야 한다고 제안했다. 여기서 중요한 것은 “실패하면 복원한다”는 제안을 바로 구현하는 것이 아니었다. 복원 과정도 다시 실패할 수 있고, 이미 변경된 인증 상태를 되돌리는 흐름은 추가적인 상태 전이와 검증 범위를 만든다.
따라서 기존 provider의 subject와 새 subject가 다르면 연결 요청 자체를 오류로 처리하는 방식을 선택했다. 상태가 바뀐 뒤 복구하는 대신, 상태 불일치가 생길 수 있는 provider 교체를 시작하지 않도록 범위를 정한 것이다.
이 판단은 코드만으로 끝내지 않았다. 기존 provider와 다른 subject의 연결 요청이 거부되는지, 이후 provider 조회나 Firebase Auth 갱신이 호출되지 않는지를 시험으로 확인했다. AI 검토가 문제를 발견한 출발점이었다면, 해결 방식은 현재 인증 흐름의 상태 변화와 실패 가능성을 기준으로 결정한 결과였다.
Apple 재가입 제안은 현재 정책에 맞춰 제한
Apple 인증에서도 검토 의견이 있었다. 탈퇴 표식이 남아 있는 동안 같은 Apple subject가 다시 가입하고 이메일을 제공하지 않으면 credential 저장과 custom token 발급이 막힐 수 있다는 내용이었다.
이 경우에도 제안된 해결 방법을 그대로 적용하지 않았다. 현재 서비스는 Apple 로그인에서 이메일을 반드시 받는 정책으로 동작한다. 이메일이 없는 재가입 경로를 새로 허용하거나 탈퇴 표식을 해제하면 기존 인증 정책과 사용자 식별 기준이 바뀔 수 있다.
그래서 이메일이 없거나 검증되지 않은 요청은 오류로 처리하는 현재 정책을 유지했다. 이메일 없는 요청에서 Firebase 사용자를 생성하거나 custom token을 발급하지 않는 시험도 추가했다.
다만 탈퇴 처리 중 credential이 다시 생성되는 위험은 별도로 수용했다. 탈퇴 표식이 기록된 사용자는 Apple credential을 새로 저장할 수 없게 하고, 기존 credential을 새 경로로 이관하지 않도록 변경했다. 탈퇴 표식이 있을 때 credential 저장이 차단되는지도 시험으로 확인했다.
하나의 검토 의견 안에서도 모두 수용하거나 모두 거부하지 않았다. 현재 서비스 정책과 충돌하는 제안은 적용 범위를 제한하고, 실제로 데이터와 인증 상태를 다시 만들 수 있는 위험은 코드와 시험으로 보완했다.
작업 흐름이 남긴 기준
이 사례에서 AI 검토는 답을 대신 내린 과정이 아니라 사람이 확인해야 할 위험을 구체화한 과정이었다.
- 검토 의견이 현재 코드에서 실제로 발생할 수 있는지 확인
- 인증 상태, Firestore 문서, 탈퇴 흐름에 미칠 부수 효과 확인
- 서비스의 이메일 필수 정책과 충돌하는지 확인
- 수용한 변경은 시험으로 재현하고 차단
- 검증하지 않은 배포나 운영 환경 결과는 주장하지 않음
역할을 나누고 검증 단계를 문서화한 이유도 여기에 있다. AI가 제안한 변경을 빠르게 받아들이기 위해서가 아니라, 변경의 영향 범위와 중단해야 할 지점을 분명히 하고 실제 서비스에 반영할 범위를 끝까지 판단하기 위해서다.
마무리
처음 목표는 Hermes에 있던 Architecture Watcher 규칙을 Codex 중심 구조로 옮기는 것이었다. 하지만 실제로 작업해 보니 역할 분리에 필요한 조건은 문서 위치보다 많았다.
- 역할 이름만으로는 책임을 구분이 힘듬
- 책임만으로는 실제 모델 선택을 보장 불가
- 문서 구조만으로는 역할을 올바르게 호출 불가
- 호출에 성공해도 결과 반환과 최종 통합 책임 필요
결국 역할 분리는 이름을 나누는 작업이 아니라 실행 계약을 만드는 작업이었다.
- 누가 계획하는가
- 누가 구현하는가
- 누가 검토하고 검증하는가
- 각 역할은 어떤 모델과 권한을 사용하는가
- 역할은 어떤 이름과 방법으로 호출되는가
- 설정한 역할을 실행할 수 없을 때 어디에서 멈추는가
현재 DevLog의 AI 역할 구조는 완성된 정답이라기보다 리포지토리에서 반복해서 사용할 수 있는 기준에 가깝다. 앞으로 역할이 추가되거나 Codex의 실행 방식이 달라지더라도 같은 순서로 판단할 수 있다.
역할을 먼저 늘리는 것이 아니라, 역할이 책임 있게 실행될 수 있는 조건부터 저장소에 기록하는 것.